AI 研究
xianyu-super-butler:先核授权与来源,不把线索当侵权定论
xianyu super butler:先核授权与来源,不把线索当侵权定论 原研究时间:2026 10 07;2026 10 13 核对修订。研究对象:Mxucc/xianyu super butler。本文只核查这一 fork,不混同上游作者或其他同名工具。 为什么暂停真实账号接入 这是一个包含多账号、自动回复、AI 议价和自动发货的项…
Research notes
不是项目说明书,而是读完、跑过、拆开以后留下的判断。
xianyu super butler:先核授权与来源,不把线索当侵权定论 原研究时间:2026 10 07;2026 10 13 核对修订。研究对象:Mxucc/xianyu super butler。本文只核查这一 fork,不混同上游作者或其他同名工具。 为什么暂停真实账号接入 这是一个包含多账号、自动回复、AI 议价和自动发货的项…
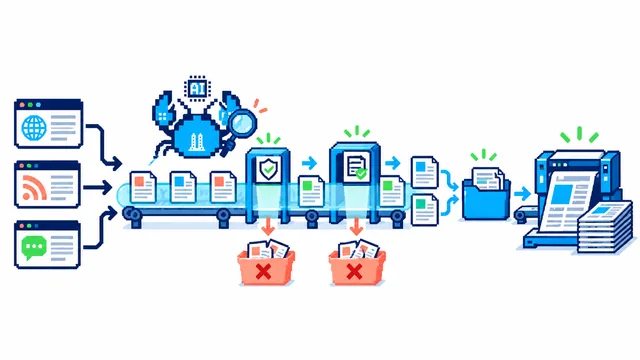
AIHOT 把采集、筛选、结构化、写作、事件归组和成刊放在一条可配置流水线里。 换信源和行业标准,就可以研究自己的资讯站;但它更像需要校准的编辑部,不是输入一堆网页就自动获得可信新闻的机器。 作者说明,公开仓库是线上引擎的导出,不能保证每次线上变化都同步;真实运营信源和一部分 AIHOT 专属功能没有包含在内。因此,开源仓库、演示站和未来…
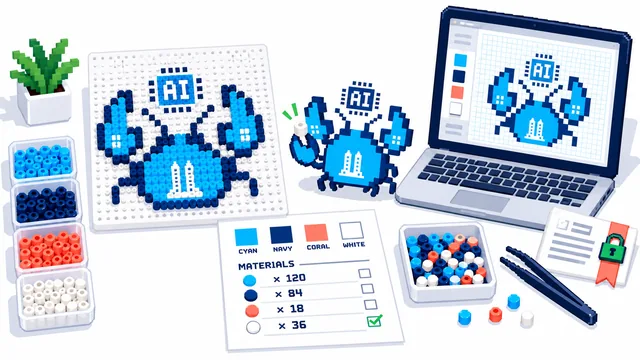
一个本地拼豆技术 MVP:把图片转图纸,或给已有品牌色号图纸做库存检查与报价资料。值得学的是“不让 LLM 猜关键数字”和“两道人审门”,不是把源码包当成已经合规验收的门店系统。 像一家小作坊:颜色、颗数、库存、报价各有账本,最后还得拿真实材料与规则核对。确定性计算保证执行同一算法,不保证输入正确或实物颜色必然一致。
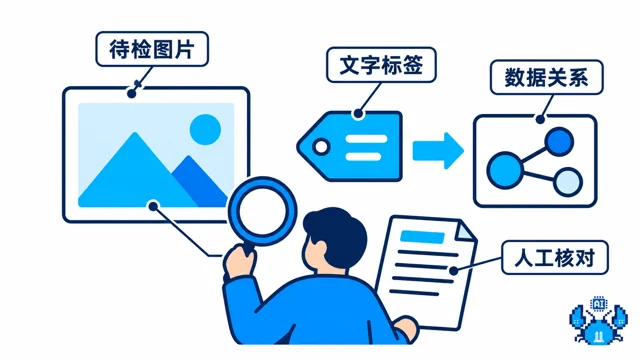
归藏把“文档配图”整理成了可插拔的 Agent Skill :给文章、截图或数据,让 Agent 选择构图、压短标签,再调用可用的图像工具生成中心图。它的卖点是 短标签、数据核对和统一视觉的工作流 ,不是自行生成图像,也不保证中文或数值一次正确。 比喻 :图像模型像一位会画画、也可能写错字的画师,这个 Skill 像给它配的质检清单:标签…
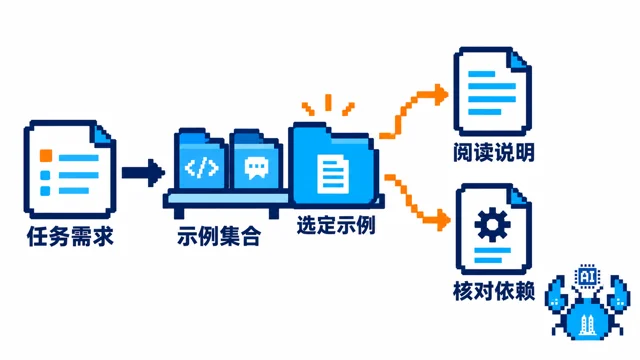
给“读完框架文档,却还不知道第一个项目怎么组织”的人准备的一本可执行菜谱。 它不是只有外链,而是包含 Agent、RAG、多智能体、语音、记忆、MCP 等方向的代码、说明和依赖。 “有代码”是优势,但不能进一步说“全由维护者亲手写、全部端到端测过、三条命令必定跑通”。不同目录是不同项目,模型、密钥、外部服务与运行入口各不相同。Apache…
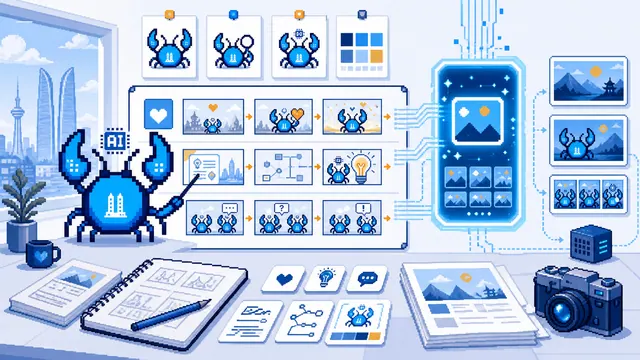
给文章配图的 Agent Skill、角色库与图像 API 适配器 。重点不是多按几次生成,而是先读文章、找值得可视化的认知锚点,再让固定角色服务于图意。 这更像一个有方法的设计助理:能减少从零开始的随意性,但不会因为用了同一张参考图就永远不跑偏。角色、文字、箭头和事实仍要看实际成图。
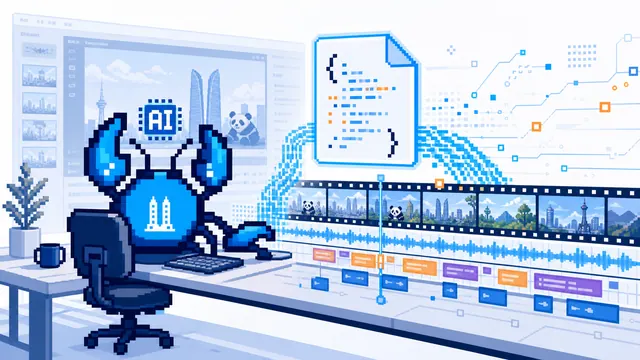
给 AI Agent 用的剪映自动化工具库 :把自然语言要求转成 Python 操作,写入剪映草稿数据,再在剪映里检查和导出。它不是一个能自动判断所有节奏、版权和画面质量的真人剪辑师。 我看重的是“绕过大量重复点击,直接组织时间轴”。但直接写工程文件也意味着:格式兼容、原稿保护和最终验收必须自己管,不能只看生成了 JSON 就算成功。
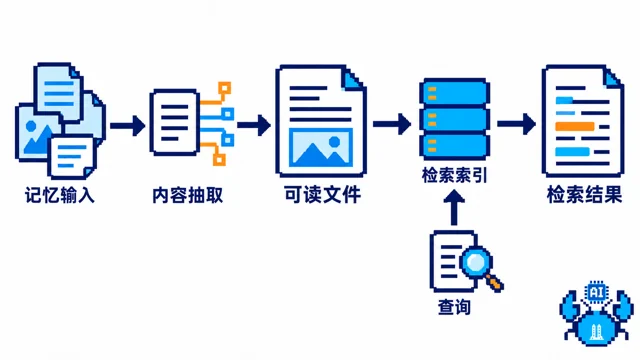
把 Agent 的记忆从一段临时提示词,变成可持久化、检索和整理的系统。它最吸引我的地方,是把 Markdown 作为可读的记忆真源,而不只留下难以检查的向量。 “用户拥有”更多指本地存储和可迁移的设计取向,不代表记忆天然正确、不外发或已加密,也不是接上所有聊天产品就会自动共用的跨平台记忆。
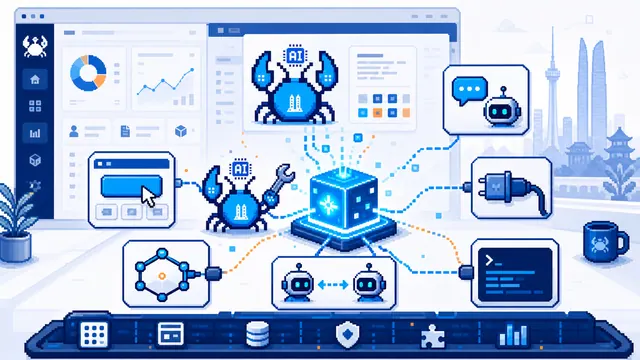
一个把 Agent 作为应用入口之一的框架。最值得学的不是聊天框,而是 把业务动作、参数校验和权限边界收在一处,让 UI 和 Agent 调用同一套实现 。 比如“创建工单”:按钮和自然语言入口不该各写一份不同的权限逻辑。共享 action 可以降低分叉,但是否真做到一致,还要看你的 action 实现和各入口认证。