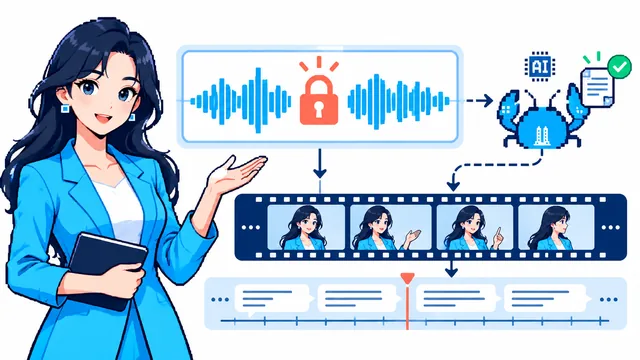
内容生产
lanshu-create-ai-presenter-video:按能力编排数字人和讲解视频
这个 Skill 的灵魂,是先把声音和验收顺序定下来,再按真实能力选择工具;数字人只是其中一条路线,授权和费用都不能靠 MIT 或 task ID 代办。 2026 10 13 资料核对:已阅读官方 README、生成参考、初始化代码、MIT 许可,以及 MiniMax 价格与统一条款原页;未提交人物或声音、未生成视频。API 专属条款与…
Research notes
不是项目说明书,而是读完、跑过、拆开以后留下的判断。
这个 Skill 的灵魂,是先把声音和验收顺序定下来,再按真实能力选择工具;数字人只是其中一条路线,授权和费用都不能靠 MIT 或 task ID 代办。 2026 10 13 资料核对:已阅读官方 README、生成参考、初始化代码、MIT 许可,以及 MiniMax 价格与统一条款原页;未提交人物或声音、未生成视频。API 专属条款与…
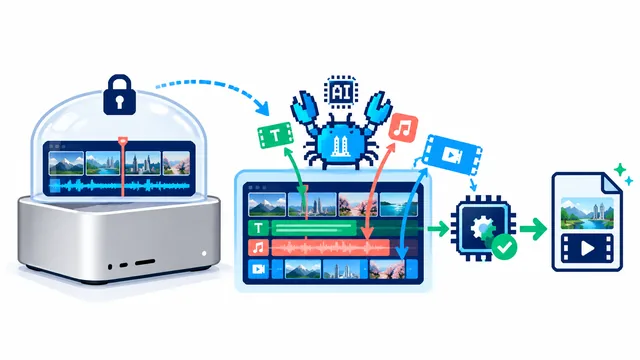
jianying headless 的灵魂,是把剪映草稿与本地导出做成可检查的自动化环节;适用版本、已知缺帧问题和非商业许可,都是使用前必须接受的边界。 2026 10 13 资料核对:已阅读官方 README、LICENSE 与验证状态原文件;本篇未构建桥接、安装剪映或导出视频,维护者的测试记录未记作本次实测。
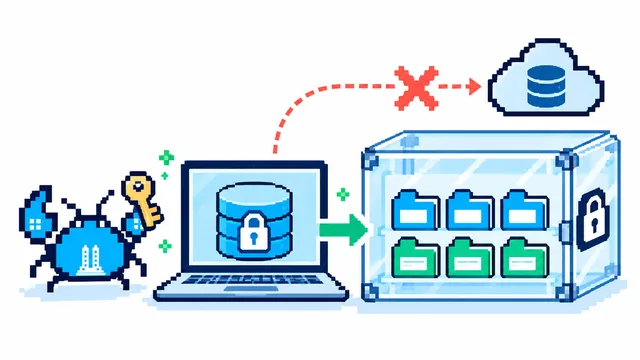
把本地聊天变成可查询资料,真正要学的是获取、明文、查询、导出四个边界怎么分开。 2026 10 13 资料核对说明: 实际读取官方 README、SKILL.md、extract keys.py、decrypt all dbs.py、vault cli.py、Windows 快照文档和根 LICENSE;未运行抓钥、解密、真实账号兼容测试…
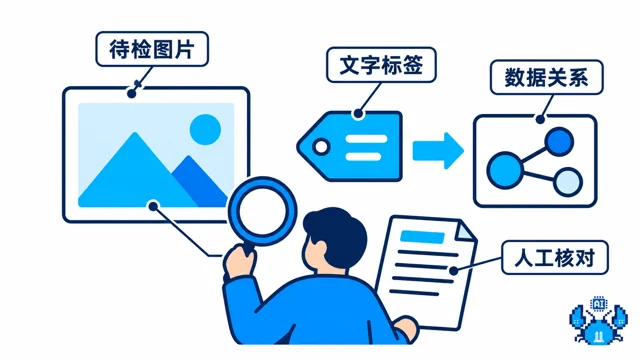
归藏把“文档配图”整理成了可插拔的 Agent Skill :给文章、截图或数据,让 Agent 选择构图、压短标签,再调用可用的图像工具生成中心图。它的卖点是 短标签、数据核对和统一视觉的工作流 ,不是自行生成图像,也不保证中文或数值一次正确。 比喻 :图像模型像一位会画画、也可能写错字的画师,这个 Skill 像给它配的质检清单:标签…
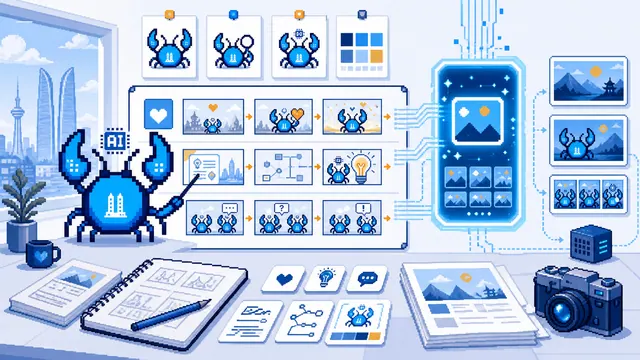
给文章配图的 Agent Skill、角色库与图像 API 适配器 。重点不是多按几次生成,而是先读文章、找值得可视化的认知锚点,再让固定角色服务于图意。 这更像一个有方法的设计助理:能减少从零开始的随意性,但不会因为用了同一张参考图就永远不跑偏。角色、文字、箭头和事实仍要看实际成图。
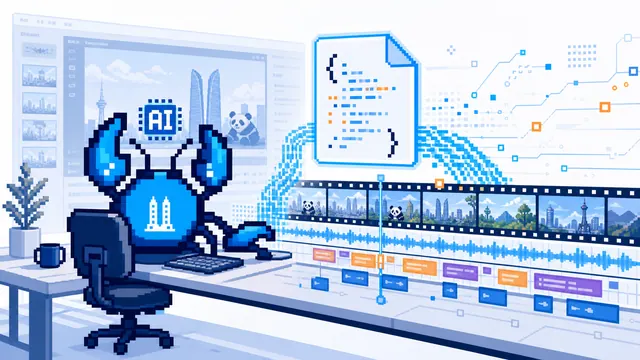
给 AI Agent 用的剪映自动化工具库 :把自然语言要求转成 Python 操作,写入剪映草稿数据,再在剪映里检查和导出。它不是一个能自动判断所有节奏、版权和画面质量的真人剪辑师。 我看重的是“绕过大量重复点击,直接组织时间轴”。但直接写工程文件也意味着:格式兼容、原稿保护和最终验收必须自己管,不能只看生成了 JSON 就算成功。
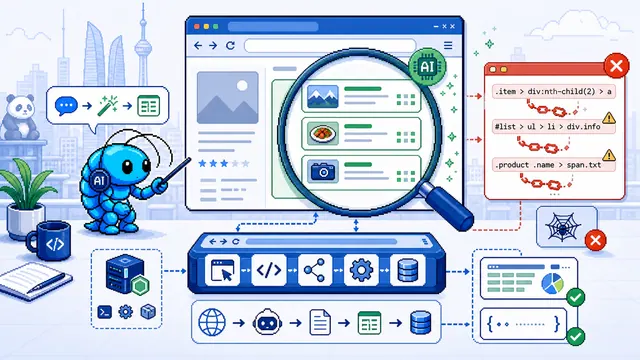
x crawl 项目研究报告 GitHub: coder hxl/x crawl 作者: coder hxl License: MIT 语言: TypeScript / Node.js 定位: 基础抓取与可选 AI 解析组合的 Node.js 库 这是什么 它像一个会读网页的实习生,但还需要有人划定材料和验收标准。 基础层负责请求与浏览器…
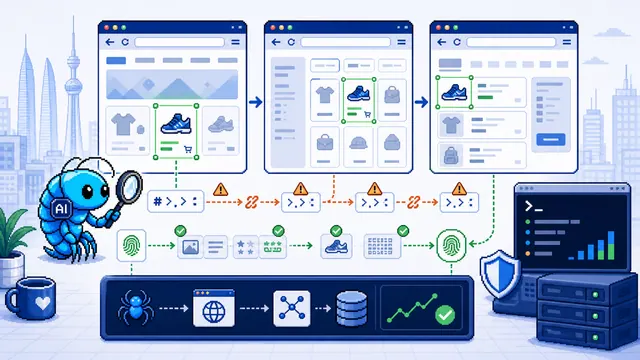
Scrapling 项目研究报告 GitHub: D4Vinci/Scrapling 作者: D4Vinci License: BSD 3 Clause 语言: Python 定位: 从单次请求到 Spider 管道的自适应 Web 抓取框架 这是什么 它是一个想减少“网站一改版,爬虫就失灵”的框架。 自适应选择器会利用之前保存的元素特征…
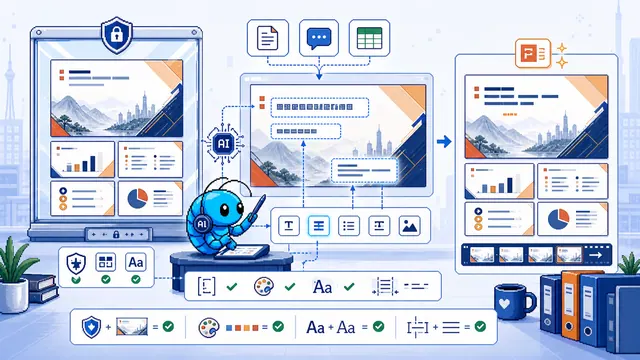
GordenPPTSkill 项目研究报告 GitHub: GordenSun/GordenPPTSkill 作者: GordenSun License: 源码/原创元数据 MIT;内置模板视觉资产另有非商业限制 语言: Python 定位: 面向 AI 的中文 PPT 生成 Skill,模板填字 + python pptx 工具链。当前…