项目:Shubhamsaboo/awesome-llm-apps 维护者:Shubham Saboo 及贡献者 类型:AI Agent / RAG 等应用示例集合 License:Apache-2.0 本文语境:原笔记记录了 2026 年 7 月的一次观察;目录与依赖持续变化,以下按 2026-10-13 可读取资料修订,不把旧数量和热度当现状。
「这是什么」一句话定性
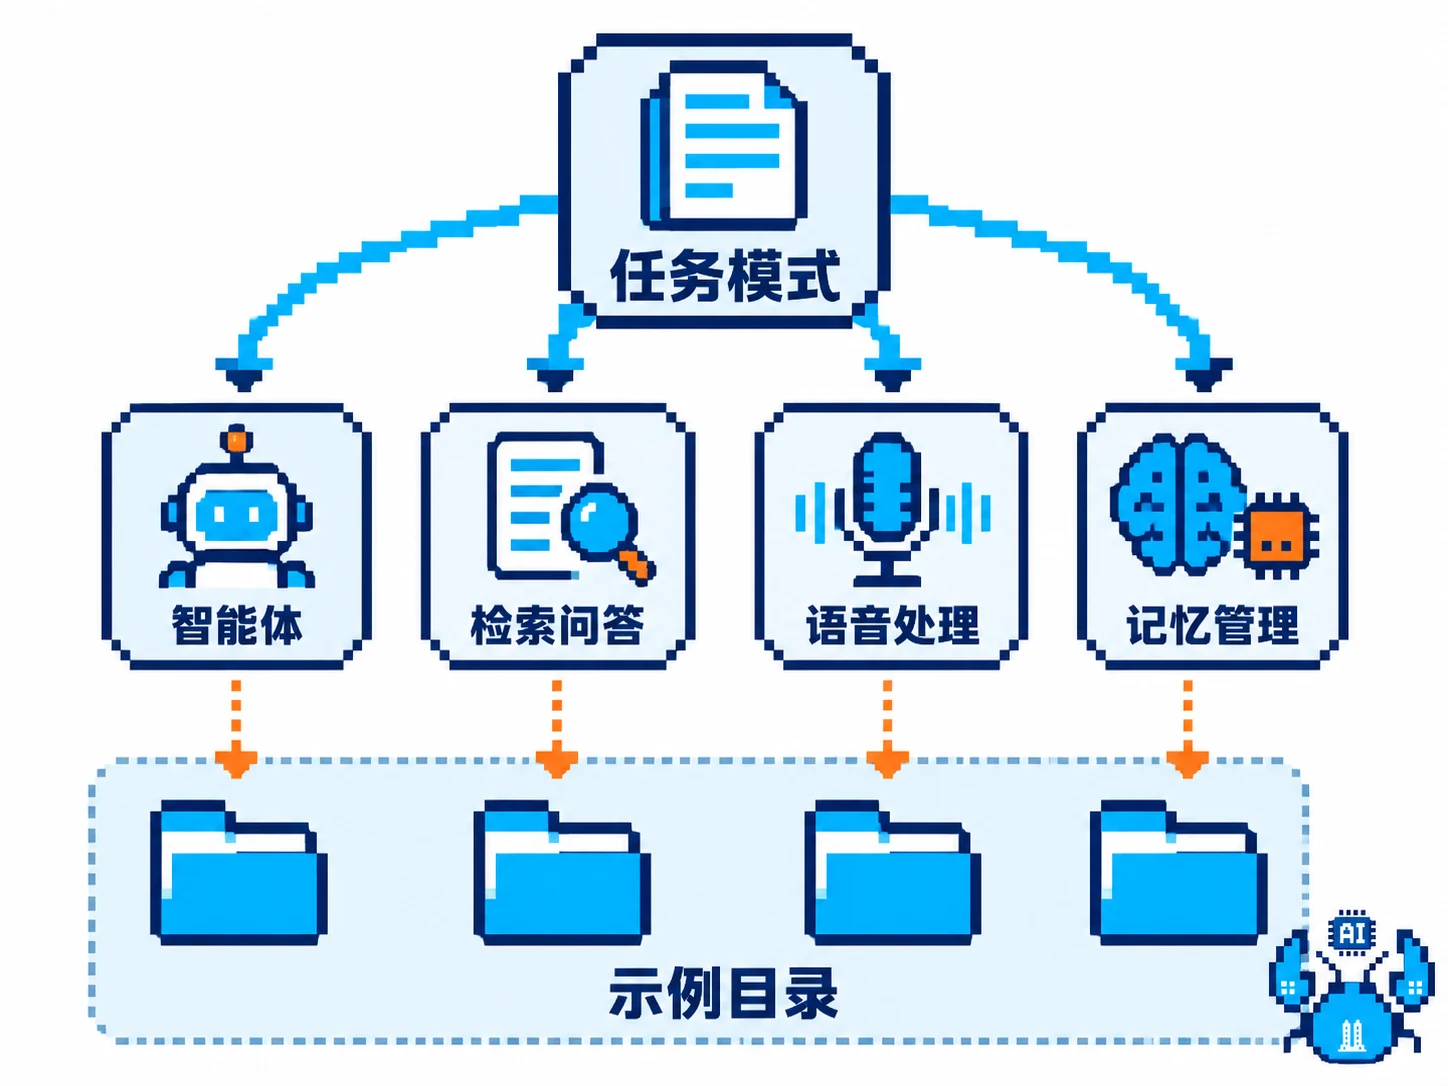
给“读完框架文档,却还不知道第一个项目怎么组织”的人准备的一本可执行菜谱。 它不是只有外链,而是包含 Agent、RAG、多智能体、语音、记忆、MCP 等方向的代码、说明和依赖。
“有代码”是优势,但不能进一步说“全由维护者亲手写、全部端到端测过、三条命令必定跑通”。不同目录是不同项目,模型、密钥、外部服务与运行入口各不相同。Apache-2.0 允许按条件复用仓库软件,也不自动覆盖模型权重、数据、商标或第三方服务。
「它怎么转」逻辑全景图
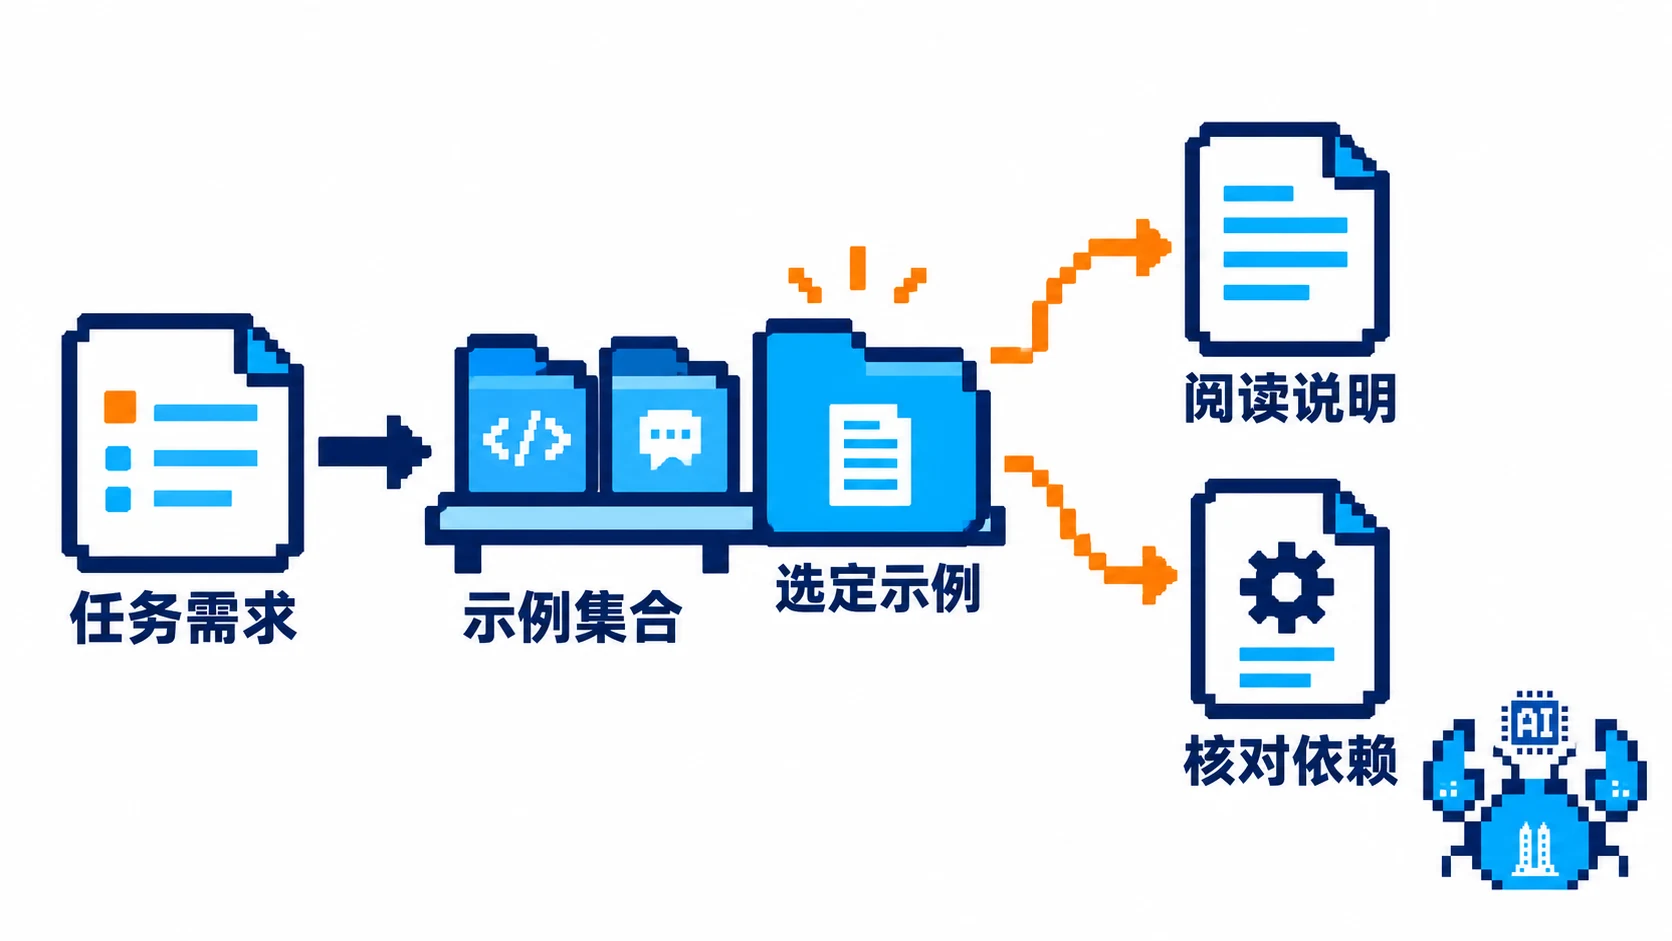
需求 → 在目录中选一个相近示例 → 阅读该目录说明和依赖
                                      ↓
                         配置模型/外部服务/测试材料
                                      ↓
                              运行与检查输出
                                      ↓
                           评估后再做产品工程化
主 README适合当地图,不是统一安装手册。当前技能目录为 agent_skills/,不要继续照抄旧文的 awesome_agent_skills/。技能规则、框架速成课和可运行应用也不是同一种交付物,不能把一个目录里的兼容性声明套到所有示例。
对代码质量,最好问更具体的问题:依赖锁定了吗?模型名还有效吗?异常分支怎么处理?是否把敏感材料传给远端?有无覆盖真实业务的测试?star/fork 比和少量 open issues 回答不了这些。
「怎么升级」三段位路线图
| 段位 | 目标 | 做法 |
|---|---|---|
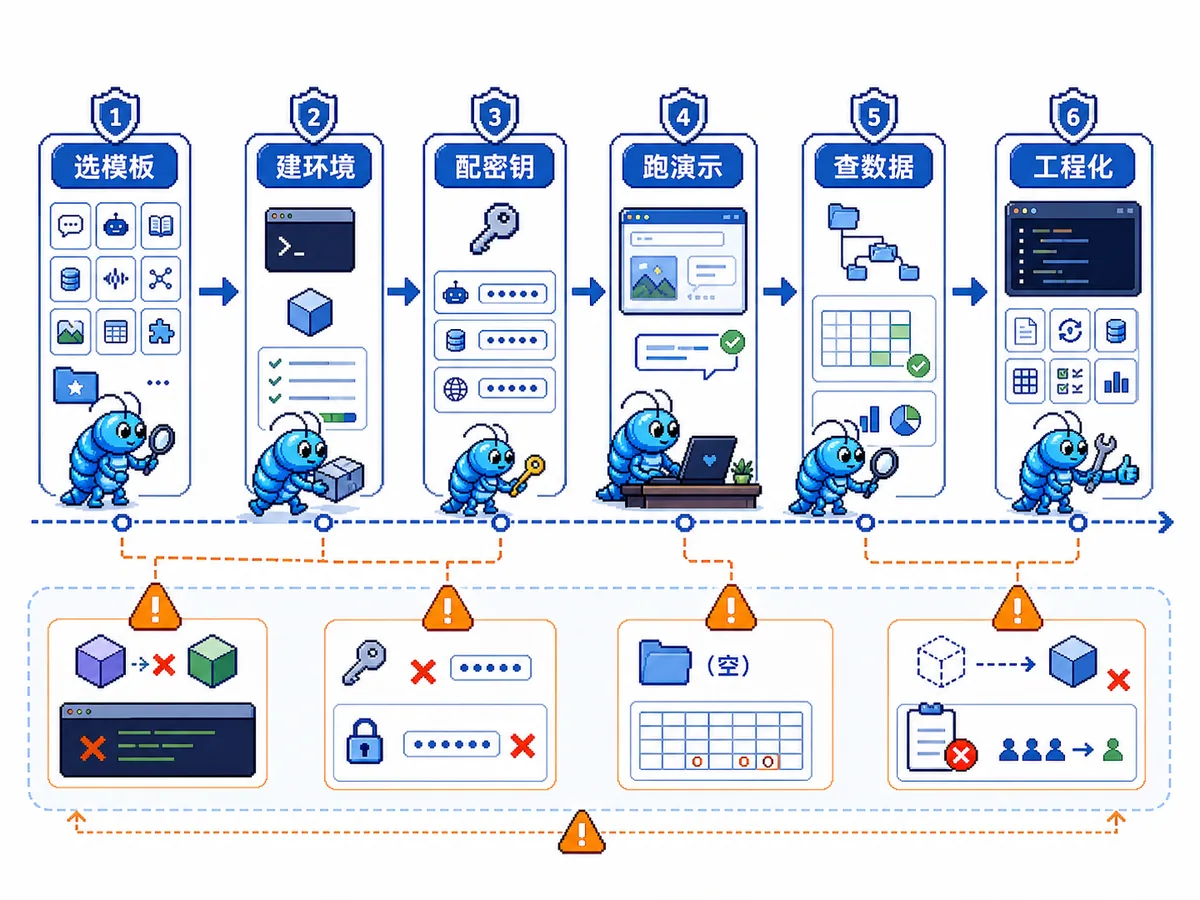
| 入门 | 跑一个小示例 | 建独立环境,按该目录 README 安装,使用非敏感测试材料 |
| 进阶 | 理解业务闭环 | 看输入、模型/工具调用、存储和输出,给结果加验收标准 |
| 高手 | 改成可维护服务 | 补认证、权限、评测、日志脱敏、预算、重试和部署测试 |
以旅行助手为例,已读取的目录 README.MD与travel_agent.py使用 Streamlit,并由界面输入 OpenAI 与 SerpAPI keys:
git clone https://github.com/Shubhamsaboo/awesome-llm-apps.git
cd awesome-llm-apps/starter_ai_agents/ai_travel_agent
pip install -r requirements.txt
streamlit run travel_agent.py
先创建并激活独立 Python 环境。这个目录没有原文所写的 .env.example,因此删除 cp .env.example .env 这一步。以上只核对了示例文件与文档,未执行。目录另有本地模型版本,但“本地 LLM”并不代表搜索工具、API 或整个流程都离线。
「能用在哪」场景迁移建议
底层逻辑(这个仓库本质上在做什么?)
把分散的应用模式变成可以读代码、比较结构的参考。学习价值在于看清一个最小闭环怎么接起来,不在于“模板越多,就越接近生产完成”。
至少 2 个可直接平移的场景
- 内部知识问答原型:拿 RAG 示例研究分块、检索、引用和失败样本;接公司文档前检查权限、远端模型和日志,别把演示引用当成正确性证明。
- 研究或旅行规划草稿:用工具调用示例组织信息和来源。时刻、价格、目的地规则要回到当前官方资料,不直接把模型建议当成预订或支付依据。
- 客服与任务分派探索:多 Agent 示例可以启发分工,但多角色不保证更准确、更便宜,也可能只是重复同一错误。
- 健康、法律和金融示例学习:可研究界面和流程,不据此宣传临床、法律或投资效果,也不直接面向真实高风险决策上线。
如果你部署了 awesome-llm-apps,会有什么好处和风险?
好处:可以少花一些从空文件搭样例的时间,并横向比较框架和任务模式。节省多少不能在未试用时用“30 秒”或“三条命令”概括。
注意事项:每个目录分别看 requirements、运行入口和 key 读取方式。不要把真实 API key 提交进仓库,也不要让日志、截图或共享会话泄露它。固定依赖和模型后再留一套可重复任务集。
风险:模型更新、第三方工具失效、提示注入、数据外发和示例缺少生产治理都可能影响结果。项目的测试或 CI 声明应按具体范围理解,不能改写为所有模板都经过端到端、安全或专业领域验证。
灵魂一句话
这仓库的灵魂不是“awesome”,而是让应用模式落到可读代码。 能不能在你的环境运行、能不能解决你的问题,要在选定示例后回答。
我的判断
我会把它当学习地图和原型起点,不当已经验收的成品库。选一个和真实任务接近的目录,读懂它的输入、外部依赖和失败路径,比统计模板数量、热度或“含金量”更有用。
资料核对:2026-10-13,读取官方总 README、旅行助手 README/源码与许可证;未安装或运行示例,未验证全部目录的依赖、模型兼容性或生产效果。