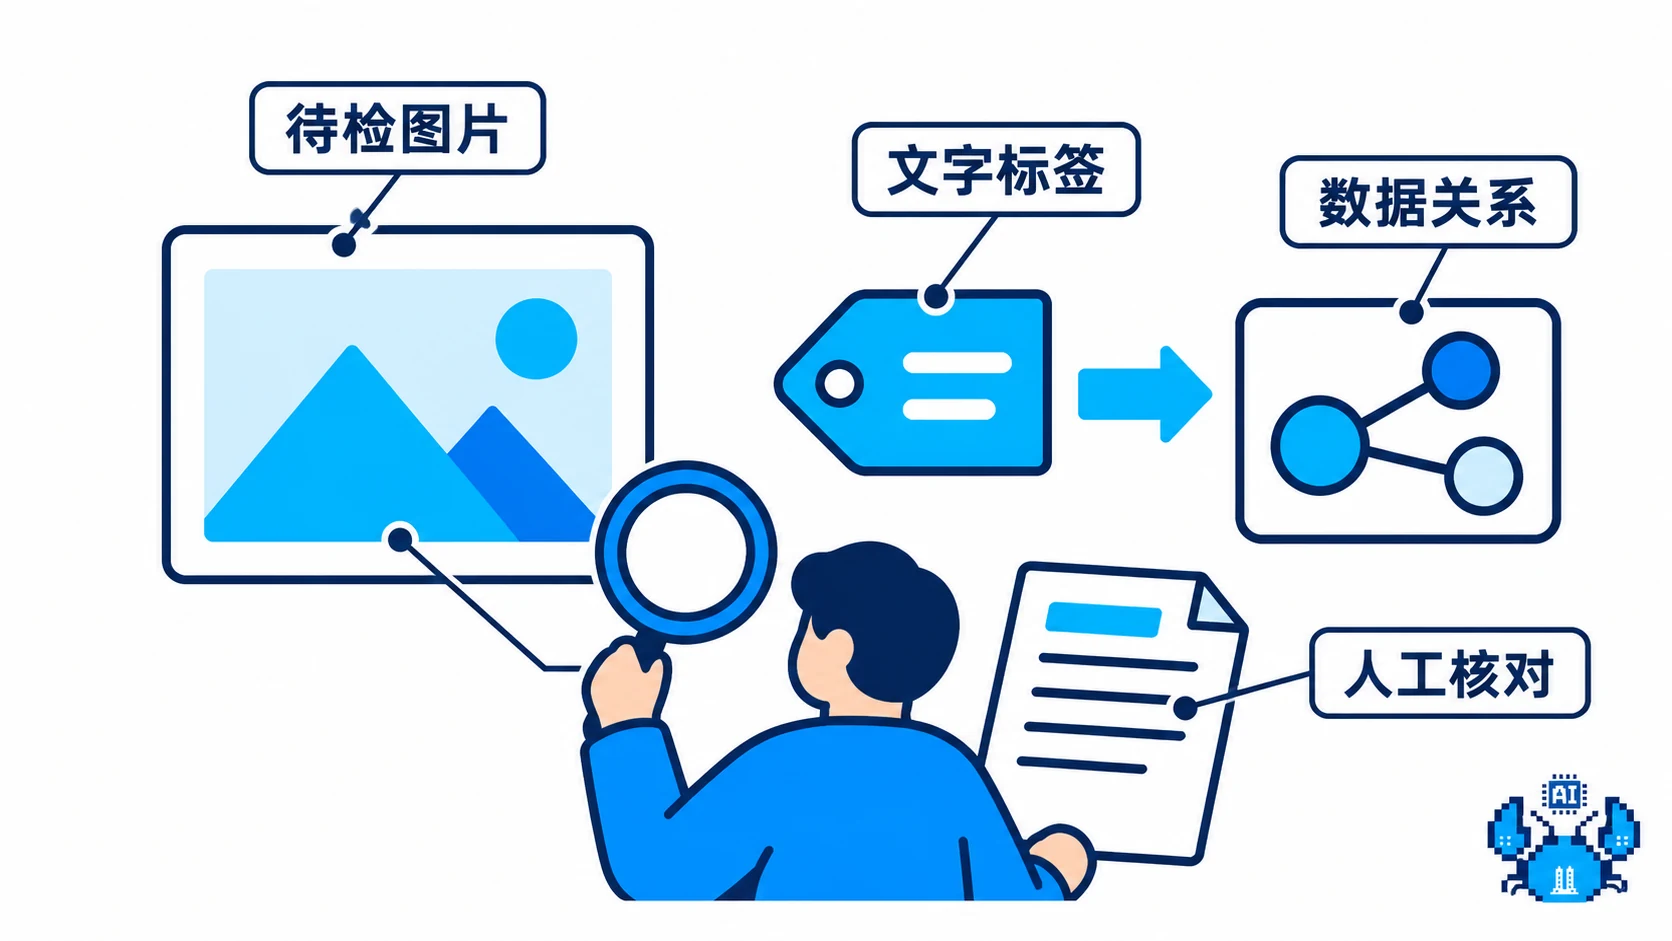
项目:op7418/guizang-material-illustration 作者:归藏(op7418)— 国内知名 AI 设计博主、产品设计师 类型:Claude Code / Codex Agent Skill(带字解释图、图表美化、参考辅助配图) License:本次检查仓库根目录及 README,未见明确 LICENSE/复用许可,商用或分发范围待向权利人澄清 历史语境:原稿写于 2026-07-08,记录 163 stars / 12 forks / 0 issues;这些旧快照不作为当前热度、成熟度或生产可用证据 语言:Markdown(SKILL.md + 6 个 references + 1 个 prompt-template,全文档驱动) 交付形式:技能文档、references、提示词模板及 Agent 展示配置,不是独立生图模型或渲染器 项目教程:README 与 SKILL.md 配套项目:guizang-social-card-skill / guizang-ppt-skill,按职责组合,不凭星标认定成熟度
「这是什么」一句话定性
归藏把“文档配图”整理成了可插拔的 Agent Skill:给文章、截图或数据,让 Agent 选择构图、压短标签,再调用可用的图像工具生成中心图。它的卖点是短标签、数据核对和统一视觉的工作流,不是自行生成图像,也不保证中文或数值一次正确。
比喻:图像模型像一位会画画、也可能写错字的画师,这个 Skill 像给它配的质检清单:标签对吗、数值对吗、箭头指对了吗?错了就退回修改提示词、再生成。它专注“配图层”,不是整篇文档排版器;没有版本演进证据,不把它定为另一个同名或近名项目的“拆分升级版”。
「它怎么转」逻辑全景图
├─ 触发层:什么时候需要翻这个 Skill?
│   ├─ 写公众号/小红书文章:要中间那张"能讲清概念"的配图,不是封面也不是装饰
│   ├─ 做 PPT 汇报:每页 PPT 中间需要一张解释图
│   ├─ 周报/项目复盘:要把"进展/风险/决策/下周"画成四象限
│   ├─ 教程/教育内容:杠杆原理、PKCE 流程、生态系统等需要"图内带字"的解释图
│   ├─ 数据图表美化:拿到一张丑截图,重新画成"数据正确+风格统一"的传播图
│   └─ 冷门概念可视化:Andon、Zettelkasten、Panopticon、模型 Logo 等要先查参考再画
│
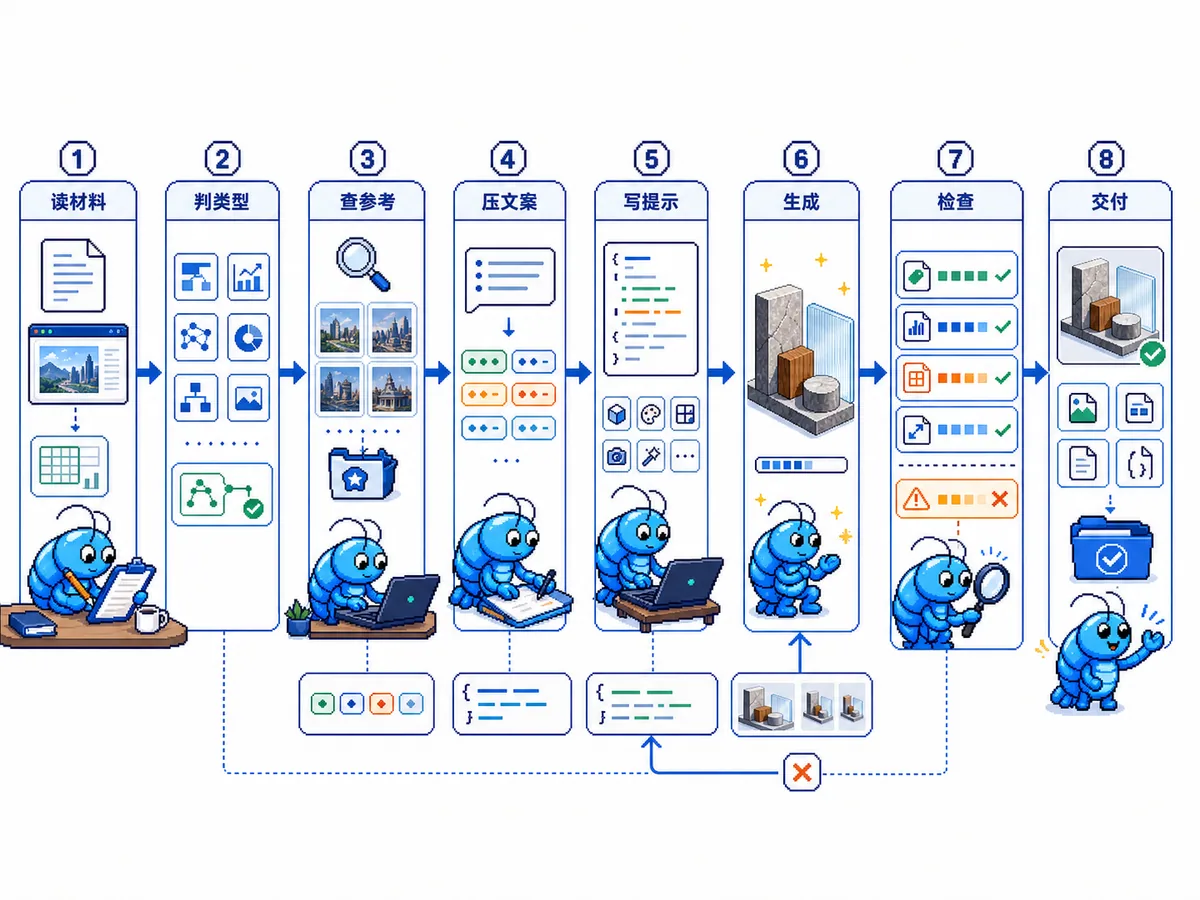
├─ 核心层:Skill 怎么工作?8 步工作流
│   ├─ Step 1 读材料:读用户文本/截图/数据,找出"真正需要被画出来的关系"
│   ├─ Step 2 内部判断类型:不让用户选模式,Agent 自己判断(流程/机制/图表/人文/教育)
│   ├─ Step 3 必要时查参考:冷门概念、品牌、模型、科学装置、历史物件先查事实+参考图
│   ├─ Step 4 压缩文案:每张图压成"一句说明 + 3-5 个短标签"
│   ├─ Step 5 写生成提示词:明标签、数据、比例、安全区、视觉风格、参考线索
│   ├─ Step 6 生成图片:调用 GPT-Image / imagegen 或当前 Agent 可用的图像能力
│   ├─ Step 7 检查并重生:中文标签、数据、裁切错了 → 作者优先建议重生;不是任何外层排版都被禁止
│   └─ Step 8 交付资产:保存图片路径+提示词到 local-tests/<slug>/
│
├─ 8 种视觉结构(prompt-patterns.md 提供的"积木")
│   ├─ Cycle 循环:3-4 个对象围成圆圈 + 箭头(适合反馈回路、迭代飞轮)
│   ├─ Pipeline 管线:左到右的对象链 + 必要时返回线(适合流程、生命周期)
│   ├─ Hub-and-spoke 中心辐射:中央路由 hub + 多分支(适合多 Agent 编排、分类)
│   ├─ Before/After 对比:左右两态 + 中间转换(适合升级、迁移、清理)
│   ├─ Layer Stack 分层栈:垂直层 + 旁边标签(适合架构、依赖)
│   ├─ Data-First Scene 数据场景:图表嵌入场景(适合传播性数据可视化)
│   ├─ Scientific Mechanism 科学机制:部件+力+反应+方向(适合物化生)
│   └─ Text Scene 文字场景:文学/历史/日常场景锚定抽象概念(适合人文)
│
├─ 视觉系统(visual-style.md 锁死的"归藏材质插画"定义)
│   ├─ 默认:clean Swiss editorial 3D vector-like
│   ├─ 背景:off-white(米白)+ 黑色 ink 线条 + 浅灰物理表面
│   ├─ 强调色(5 选 1,**不混用**):
│   │   ├─ IKB Blue #002FA7:技术/AI/工作流(**默认**)
│   │   ├─ Safety Orange #FF6B35:警示/决策/迁移/风险
│   │   ├─ Lemon Green #C5E803:增长/复利/健康/财务
│   │   ├─ Lemon Yellow #FFD500:教学/总结/初学者指南
│   │   └─ Signal Red #E60012:失败/阻塞/严格审查(克制使用)
│   ├─ 比例:1.9:1(社交卡片 image well 936x500)/ 16:9(PPT hero)/ 1:1(少见)
│   └─ 反模式(do not):装饰 blob、bokeh、渐变球、stock-photo 背景、Logo、水印、密集图例
│
├─ 中文图内文字规则(**整个 Skill 的核心差异化卖点**)
│   ├─ 2-5 字短标签为佳,6 字封顶
│   ├─ 3-5 个标签/张图
│   ├─ 位置明确:top-left/center/right、bottom-center、right edge
│   ├─ 水平、高对比、远离边缘
│   ├─ 用日常中文,不用 "Trigger/Stop/Use" 等英式 UI 标签
│   └─ 错了就重生,不靠 HTML 硬贴(核心原则)
│
├─ 图表美化的"数据优先"原则(chart-beautify.md)
│   ├─ 输入是截图时,**只抽语义不抽视觉**:保留图表类型/标题/数据/坐标/单位/误差线
│   ├─ **不继承**:原配色、原字体、原 bar 形状、原间距、原阴影、原背景
│   ├─ 两种重画模式:
│   │   ├─ Faithful Chart Redraw:原图布局好时,只换皮
│   │   └─ Data-First Editorial Composition:默认模式,让图表占 45-70% + 周围配场景
│   └─ QA 严格:轴范围、刻度、类别顺序、数值、误差线,错一个就重画(不放过)
│
└─ 输出层:怎么判断 Skill 是不是用对了?
    ├─ 配图适合放进小红书/公众号/PPT/文章的目标尺寸
    ├─ 人工核对短标签、箭头、数据和单位,再决定能否交付
    ├─ 单图资产可复用(提示词+图片路径都存了)
    └─ 风格跨图集一致(统一 off-white + 统一 accent 色)
│
└─ 卡点层:新手最容易在哪里翻车?
    ├─ 卡点 1:以为这是"万能生图 skill"——其实只做中心配图,不做完整社交卡片(标题/正文/尺寸归 Social Card Skill 管)
    ├─ 卡点 2:在图内硬塞长文——2-5 字是建议,通常 6 字封顶;长解释留给外层正文
    ├─ 卡点 3:用贴字掩盖错数据——作者偏好重生;需要可编辑精确文字时可另选确定性排版方案
    ├─ 卡点 4:以为参考搜索 = 抄风格——错,参考只补事实和视觉线索,最终统一归藏材质插画
    ├─ 卡点 5:图表截图"换皮"——错,只抽语义不抽视觉,原图丑排版就重画
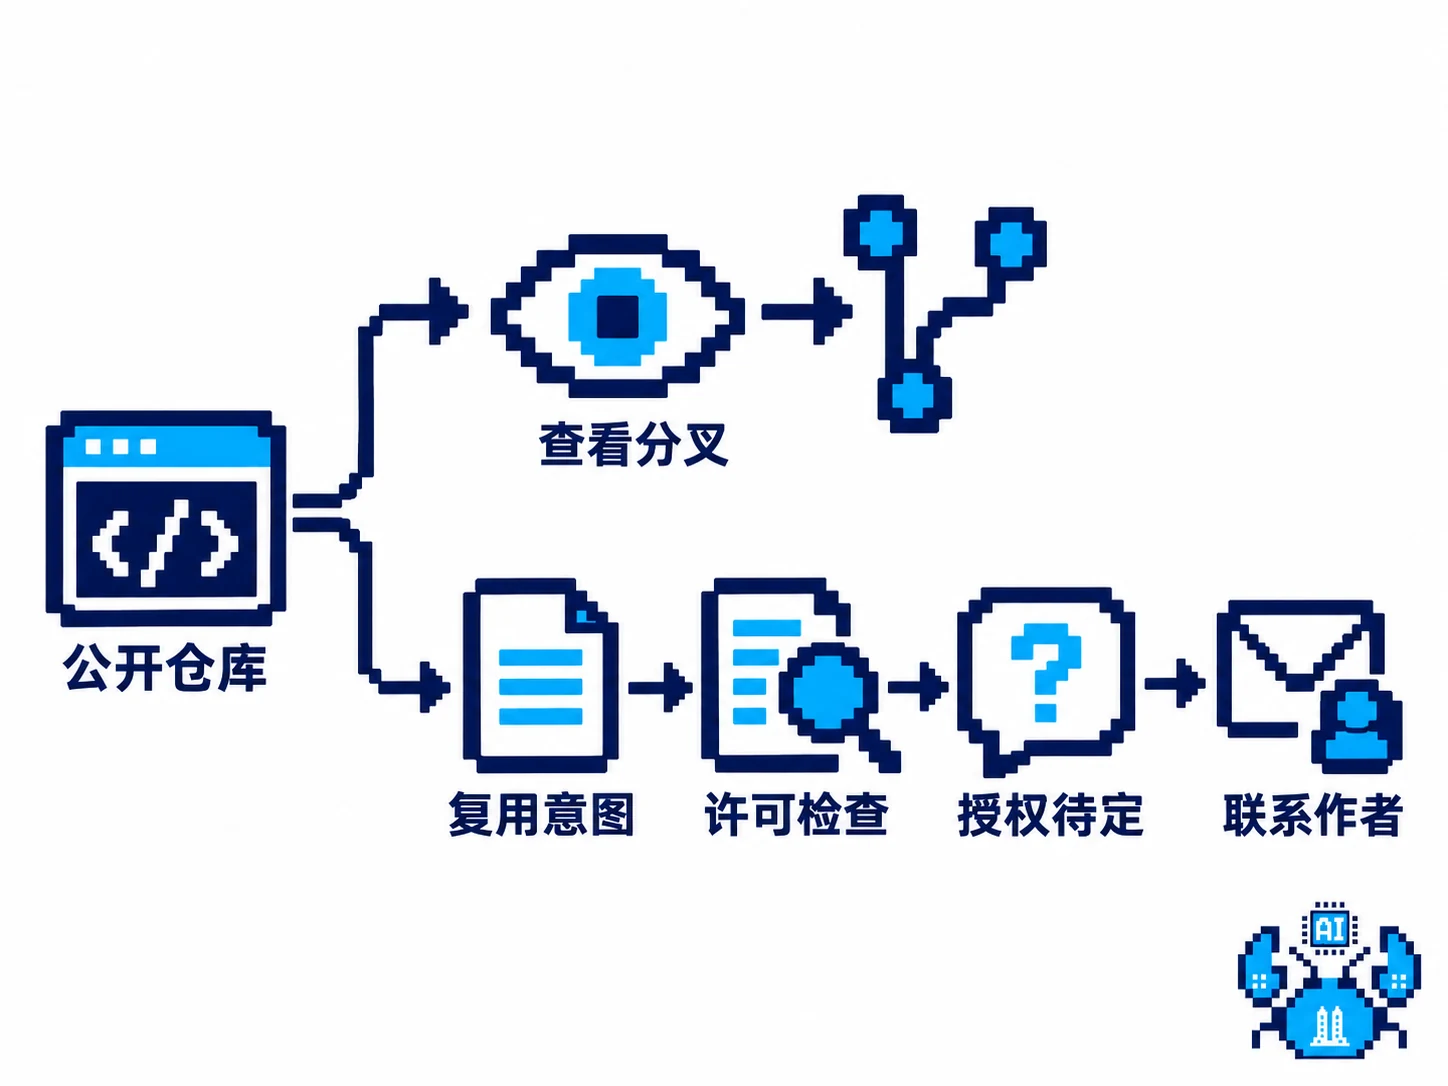
    └─ 卡点 6:公开不等于许可明确——本次未找到 LICENSE,复用、分发或商用前澄清授权
上面的 IKB Blue 等名称、HEX 与场景对应,是项目自定的视觉约定,不是颜料/印刷色彩标准,也不意味着某种颜色会带来健康、增长或财务效果。视觉规则原文
「怎么升级」三段位路线图
├─ 入门段(能用):掌握一个核心动作就够了
│   ├─ 动作:复制作者测试案例里"小学物理杠杆"那组提示词,跑通一遍
│   ├─ 步骤:
│   │   1. npx skills add https://github.com/op7418/guizang-material-illustration --skill guizang-material-illustration
│   │   2. 在 Claude Code / Codex 里说"用歸藏的材质插画 skill,给这篇杠杆原理文章做一张配图,标签:支点/用力点/阻力点/力臂"
│   │   3. 看效果:标签对吗?数据对吗?风格对吗?
│   ├─ 完成标志:读懂工作流,并能核对标签、箭头和参考来源
│   └─ 时间投入:取决于底层模型、素材和重试次数,本文没有计时
│
├─ 进阶段(用好):补两个认知
│   ├─ 认知 1:8 种视觉结构是"积木",不是"模板"
│   │   ├─ 不要硬套 prompt-patterns.md 里的现成 prompt,要拆解它的"结构 + 标签规则 + 风格锁"
│   │   ├─ 可复用的约束是:3-5 个短标签 + 统一 accent 色 + off-white 背景;比例按目标容器选
│   │   └─ 这套约束可以套到任何"AI 生图"场景,不限于归藏的 prompt
│   ├─ 认知 2:图表美化的"语义抽取"是核心能力
│   │   ├─ 拿到一张截图,先用 LLM 抽出"图表类型+标题+数据+坐标+单位+类别顺序+误差线"
│   │   ├─ 抽取后只把这 7 个字段塞进 prompt,其他一概不继承
│   │   └─ 这个工作流可以套到任何"丑图重画"场景,不限于归藏
│   └─ 时间投入:选 3 个不同领域(科技/教育/人文)各跑一遍,观察风格一致性——约 1 周
│
└─ 高手段(用活):高手和普通人的本质差距
    ├─ 差距 1:从"用归藏的 skill"变成"吃透归藏的设计哲学"
    │   ├─ 归藏的核心哲学:**"图内可以有字,但字要短;外层卡片负责长正文"**——分层处理信息密度
    │   ├─ 这是设计领域的"图与文分工"原则的 AI 化
    │   └─ 用这套原则改自己的配图,但不要给未测试的效果标百分比
    ├─ 差距 2:从"单 Skill 使用"变成"Skill 编排"
    │   ├─ 归藏的生态是矩阵:
    │   │   ├─ guizang-ppt-skill = HTML 演示文稿排版
    │   │   ├─ guizang-social-card-skill = 社交卡片排版
    │   │   └─ guizang-material-illustration = 中心配图
    │   ├─ 正确用法:先 Material Illustration 出中心图 → Social Card Skill 排卡片 → PPT Skill 排演示
    │   └─ 错误用法:试图用一个 Skill 干所有事
    ├─ 差距 3:从"用现成 prompt"变成"自己写 prompt 模板"
    │   ├─ assets/prompt-template.md 给了 1 个"通用解释图"模板
    │   ├─ 你应该基于自己领域(产品/技术/教育/金融)写 3-5 个定制模板
    │   ├─ 关键变量:accent 色、标签位置、构图比例、参考搜索清单
    │   └─ 模板沉淀后,团队可以共享成"公司级设计语言"
    └─ 差距 4:从"图本身"变成"图 + 提示词 + QA 记录"
        ├─ 归藏的 local-tests/<slug>/PROMPTS.md 模式值得学
        ├─ 把"为什么这张图这样画"(参考了什么、抽了什么、不采用什么)记录下来
        ├─ 这是可复用的"设计决策日志"
        └─ 3 个月后回看,能看出"我的设计语言在进化"还是"原地打转"
「能用在哪」场景迁移建议
底层逻辑(这个 Skill 本质在做什么?)
尝试用流程约束 AI 配图的三类常见问题: 1. 图内文字生成质量差(中文字常错字/糊/截断)→ 用"短标签+重生"流程硬扛 2. 图表截图换皮而不是真重画 → 用"只抽语义不抽视觉"原则 3. 冷门概念画错(模型 Logo、历史物件、科学装置)→ 用"参考搜索补事实"工作流
可平移的底层逻辑:把结构、风格和验收标准写清楚。提示词能减少歧义,但结果仍取决于模型、输入、生成随机性和复核;“提示词越精确就必然越准”不是成立的质量公式。
图表尤其不能只看数值标签:柱高、坐标起点、比例和误差线也要核对。截图无法可靠读出数值时,先索要数据或明确标近似;科研、财务等严格数据图优先用确定性制图库,再把装饰配图和数据层分开。项目 README 自己也将严格出版级科研图列为不适合场景。图表规则原文
至少 2 个可直接平移的场景
场景 1:中文内容创作者的"配图 SOP" - 类比:归藏的 Skill 解决"AI 配图质量不可控"问题;你的内容创作也面临同样问题 - 迁移变量: - 把 8 种视觉结构 + 5 种 accent 色作为团队"配图风格指南" - 把"3-5 个短中文标签"作为统一标准(不要在图内塞长文) - 把"参考搜索"工作流纳入 SOP(冷门概念先查) - 把"PROMPTS.md 记录"纳入交付物(可复用) - 风险:归藏的风格偏 Swiss editorial(克制、几何、米白),如果你的内容是活泼/插画/卡通风,需要调整 visual-style.md
场景 2:企业内训/技术文档的"配图自动化" - 类比:归藏针对中文内容生产的痛点;企业内训同样有大量"长文档+需要配图"场景 - 迁移变量: - 把"图表美化"工作流用于"老旧 PPT 数据图重画"——一次重画,整年复用 - 把"机制图"工作流用于"内部系统架构说明"——IT 文档配图不再靠设计师手画 - 把"教育图"工作流用于"新员工培训手册"——杠杆原理/流程图自动出 - 风险:企业场景对数据准确性要求更高,QA 流程要更严(建议加"数据双重验证"步骤)
场景 3(额外):从"AI 生图 Skill"反推"AI 生文/生码 Skill"的设计模式 - 类比:归藏的 Skill 用 8 种视觉结构 + 5 种 accent + QA checklist 组织;其他 AI 生成(文/码/视频)也面临类似问题 - 迁移变量: - 8 种结构 ≈ 8 种"内容模板"(开篇/论证/案例/总结...) - 5 种 accent ≈ 5 种"语气风格"(正式/轻松/专业/亲和/警示) - QA checklist ≈ "输出质量自检清单" - 这种"结构 + 风格 + QA"三件套,可以套到任何 AI 生成 Skill 的设计 - 风险:抽象层级高,需要根据具体领域(文/码/视频)调整 checklist 细节
如果你部署了这个 Skill,会有什么好处和风险?
好处:
- 立刻获得"AI 配图 + 中文标签"的可控工作流(之前只能靠反复试 prompt)
- 8 类结构和一组强调色帮助统一提示词;没有对照实验,不能说风格一致性提高 5-10 倍
- 可按项目文档与归藏 PPT/社交卡片工作流组合,实际接入与授权分别确认
- QA checklist 提供人工验收条目,不是自动测试套件;issues 数量也不是生产可用认证
- 安装极简:npx skills add <url> 一行搞定
注意事项:
- 许可未明确:本次目录列表没有 LICENSE 文件,不是“发现了空 LICENSE”。README 也未给出明确复用许可;在 GitHub 上查看/fork 与获得后续分发、改编、商用授权不是一回事,不能自动宣称“fork 后内部使用就合规”。GitHub 许可说明
- 需要当前 Agent 可用的图像生成工具,可能是运行时原生能力或 API;是否自备 Key、费用和数据外传条件取决于后端
- 中文标签质量受模型和内容影响;原稿的“≥99%”“80% 以下”没有可核验测试条件与数据,删除,不用模型名字替代验收
- 风格偏 Swiss editorial(克制几何),不适合活泼/插画/卡通风
- 需要整篇文档配图时,另选有文档解析和排版能力的工具;本文没有对 Document-illustrator-skill 做同题测试或匹配仓库核查,不据近名项目星标排成熟度
风险: - 版本变化:原稿“发布 1 天”只属于 2026-07-08 的历史语境,不能延续成当前年龄;应固定版本并用自己的案例检查 - 维护持续性:没有维护承诺或路线图交付证据,不能从作者仓库数、课程业务或商业化推测投入优先级 - 风格迁移成本:要换画风时,需调整视觉规则与提示词模板;读材料、短标签和 QA 等步骤仍可复用,不是整个工作流必然重写 - 参考与素材权利:参考搜索只补事实,不代表外部图片、Logo 或字体可自由改编;按实际用途确认权利
和大管家(峰哥这边)的关系
| 维度 | 关系 |
|---|---|
| Agent 接入 | 本文核到的 README 主要说明 Claude Code / Codex;其他运行时需确认技能发现方式和可用图像工具,不称一装就能用 |
| 设计哲学 | 图内短字 + 外层长文,可借鉴为我们的分层表达方式 |
| 视觉风格可借鉴 | 8 种视觉结构 + 5 种 accent = 可平移到我们做"研究汇报"插图的标准 |
| 中文标签规则 | "2-5 字短标签"规则可以直接用在我们的网站配图 SOP上 |
| 风险联动 | 发布自己的 Skill 时附清楚许可,第三方参考图和模型输出的权利另记来源 |
灵魂一句话
这仓库的灵魂是"图与文要分层"——归藏赌的是:把"图内长文/密集图例"这种 AI 生图最常见错误,从一开始就拦在 prompt 里。图只管短标签和数据精度,长解释交给外层卡片/正文。当别人还在和 GPT-Image 死磕"中文字怎么不糊"时,归藏已经用"重生 > 修补"的工程化思维把这个问题从创意领域拽进了 QA 流程。
我的判断
以下是我的文档阅读判断,不是实测评分或普遍排名。
| 维度 | 判断 | 说明 |
|---|---|---|
| 实用性 | 值得试小样本 | 中文配图的短标签和复核流程有实际需求 |
| 设计哲学 | 可借鉴 | 图文分层、少量强调色和目标尺寸验收 |
| 工程质量 | 文档驱动 | 清单完善程度不等于工具实现或自动验证覆盖 |
| 持续性 | 无法据此判断 | 不由星标、issues 数或作者其他业务推断 |
| 创新性 | 不作横向定级 | 未核实与近名项目的代码/版本关系 |
| 风险 | 许可待澄清 | 未找到明确复用许可,商用与分发先确认 |
和峰哥这边的契合度: - 可以借鉴其配图 SOP;具体 Agent 接入留待单独验证 - 图内短标签、长说明放正文,符合我们精简表达的需求 - ✅ 中文标签规则可平移到我们网站配图 - ⚠️ LICENSE 问题让我们发布自己的 SKILL 时强制带 LICENSE成为更明确的纪律 - 💡 灵感:归藏的"8 种结构+5 种 accent"模式可以套到我们做"研究汇报"插图
研究日期:2026-07-08 研究员:大管家 研究流程:RESEARCH.md 四步法(定性 → 全景 → 升级 → 迁移) 资料边界:原研究日期保留,不把旧热度、作者生态分析或无记录的体验当成本次验证结果。
资料核对(2026-10-13)
本次读取官方 README、SKILL.md、视觉规则、图表规则、QA 清单 和仓库根目录列表。未调用生图、运行工作流或比较模型准确率;许可状态只记录本次所见,不构成对作者权利或争议的法律定性。