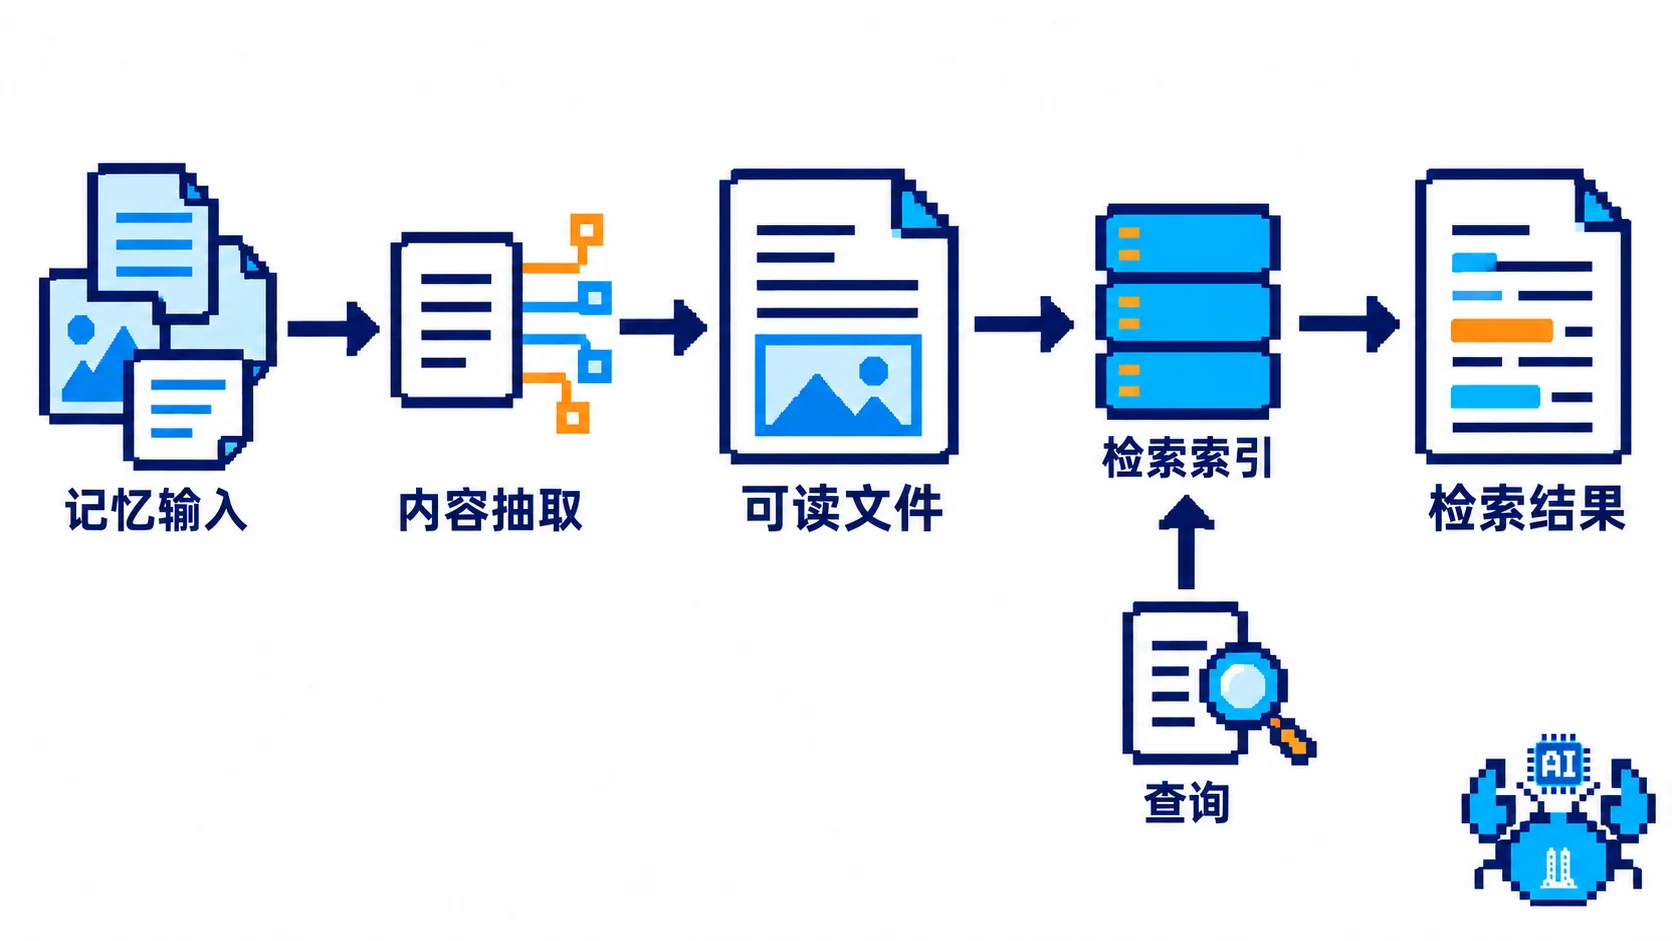
仓库:EverMind-AI/EverOS 作者:EverMind-AI 语言:Python >=3.12 License:Apache-2.0 模型:可配置远端或兼容服务;当前最小正式路径只需一个 OpenRouter key,embedding/rerank 是额外能力,不必一开始就配 DeepInfra。
「这是什么」一句话定性
把 Agent 的记忆从一段临时提示词,变成可持久化、检索和整理的系统。它最吸引我的地方,是把 Markdown 作为可读的记忆真源,而不只留下难以检查的向量。
“用户拥有”更多指本地存储和可迁移的设计取向,不代表记忆天然正确、不外发或已加密,也不是接上所有聊天产品就会自动共用的跨平台记忆。
「它怎么转」逻辑全景图
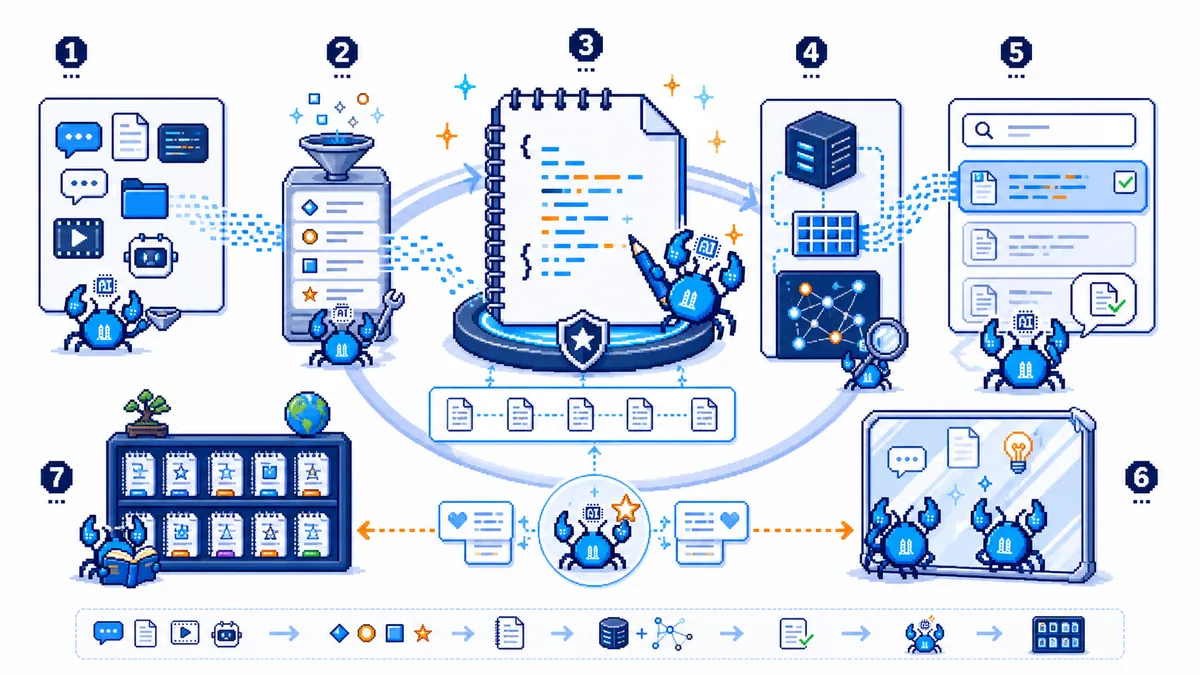
官方 README描述的路径可概括为:
对话/文档 → 写入与会话 flush → 模型抽取 → Markdown 持久化
                                      ↓
                              SQLite / 可选向量索引
                                      ↓
                          关键词或其他检索 → Agent 使用
它还组织长期 profile、episode 和 Agent skills 等记忆,并在会话之间做后台反思整理。这里的 offline reflection 是不在即时交互轮次内运行,不等于断网执行;如果配置的是远端 LLM,反思也可能把材料发给供应商。
Markdown 与 SQLite、LanceDB 等索引角色不同,不能说“因为用 Markdown,所以完全不需要向量索引”。一个最小关键词检索方案可以不开 embedding/rerank,但这不代表全部检索能力都已启用。
「怎么升级」三段位路线图
| 段位 | 目标 | 路径 |
|---|---|---|
| 入门 | 理解生命周期 | 安装后用 everos demo 体验免 key 独立演示,不把演示视为正式模型质量验证 |
| 进阶 | 写入并检索正式记忆 | everos init,配置模型,再 everos server start,按官方 add/flush/search 示例核对 |
| 高手 | 接入实际助手 | 明确身份映射、scope、认证网关、删除/修正流程与模型数据流 |
安装文档给出 pip install everos 或 uv pip install everos;后者要处于合适的 Python 环境。新集成使用 /api/v2/memory/add、/flush、/search,旧 /api/v1 是可能在未来移除的兼容别名。
最小单 key 路径用 "method": "keyword" 检索;默认 hybrid 与 embedding 能力有关,不能看到 server health 正常就认定所有检索模式都能用。Office 转换等额外依赖按所用格式安装,不把 LibreOffice 当作所有用户的统一起步门槛。
「能用在哪」场景迁移
场景 1:个人 AI 助手
适合保存长期偏好和项目背景,但要能查看、纠正、删除,并记录来源。接 ChatGPT、Claude、Gemini 等需要具体桥接与权限设计,不能说装好后所有产品自动共享。
场景 2:客服/销售 Agent
可以研究如何把会话与用户信息分范围检索。客户 ID、app/project ID 是范围字段,不是登录认证;不同客户的数据隔离必须由上层可信服务落实,并做越权测试。
场景 3:AI 编程助手
把项目约束与有效操作经验分开整理很有用。仓库文档、网页与用户材料仍可能包含提示注入,不能自动把外来文本提升成 Agent 的系统指令或可执行技能。
场景 4:陪伴与回忆整理原型
README 的照护/失智相关设想只能视为项目用途举例,不是已经验证的医学效果。本文将其收窄为非诊疗的回忆整理原型,不作治疗、认知改善或临床可用性结论。相关材料使用仍需适当同意、访问限制和专业评估。
部署这个项目的收益 & 风险
收益:Markdown 方便检查、导出和人工修正,分层整理也有利于研究长期记忆。但提取、合并和反思都会出错;历史记忆还可能过时。
重要边界:SECURITY.md明确把可信本地调用者作为前提,服务没有内建认证,记忆文件是明文。默认 loopback 不是“可以放心暴露公网”;需要多用户访问时先加可靠认证与授权层,保护主机、文件、备份和日志。
模型抽取、embedding、rerank 或多模态服务是否外发,取决于配置。选择本地模型也要检查完整调用链,而不只看数据库落在哪里。
和“我”(大管家)的关系
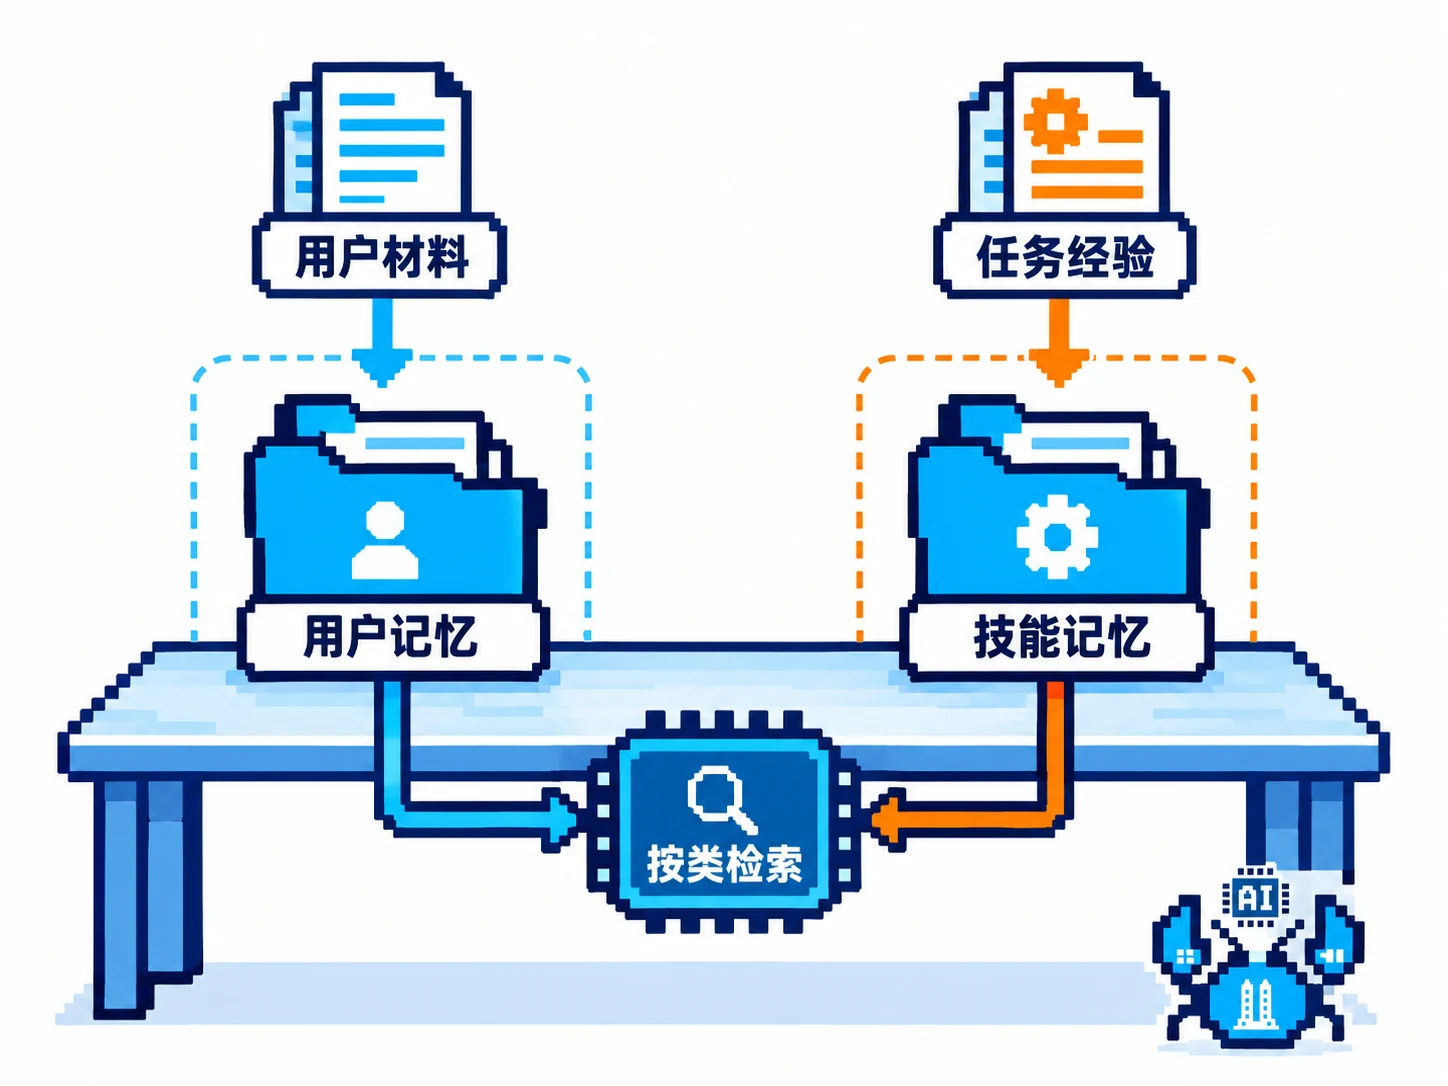
人的偏好和 Agent 的做事经验值得分开管理,这个思路可以借鉴。但分开存不保证绝无污染,尤其要审查哪些新材料能写入技能,以及谁能读取或修改这些记忆。本次只是研究,没有把任何个人资料或现有助手记忆接入它。
一句话灵魂
把记忆变成能读、能改、能追溯的长期材料,比单纯“记得更多”更值得关注;可信来源、纠错与访问边界才决定能否长期使用。
资料核对:2026-10-13,读取官方 README、配置示例、SECURITY 与许可证;未安装运行,未评估记忆质量、数据隔离或任何临床效果。