原研究日期:2026-10-01;资料核对:2026-10-13。研究对象:KKKKhazix/AIHOT。 本文只修订研究笔记,不改本站历史新闻、新闻任务或发布配置。
一句话定性
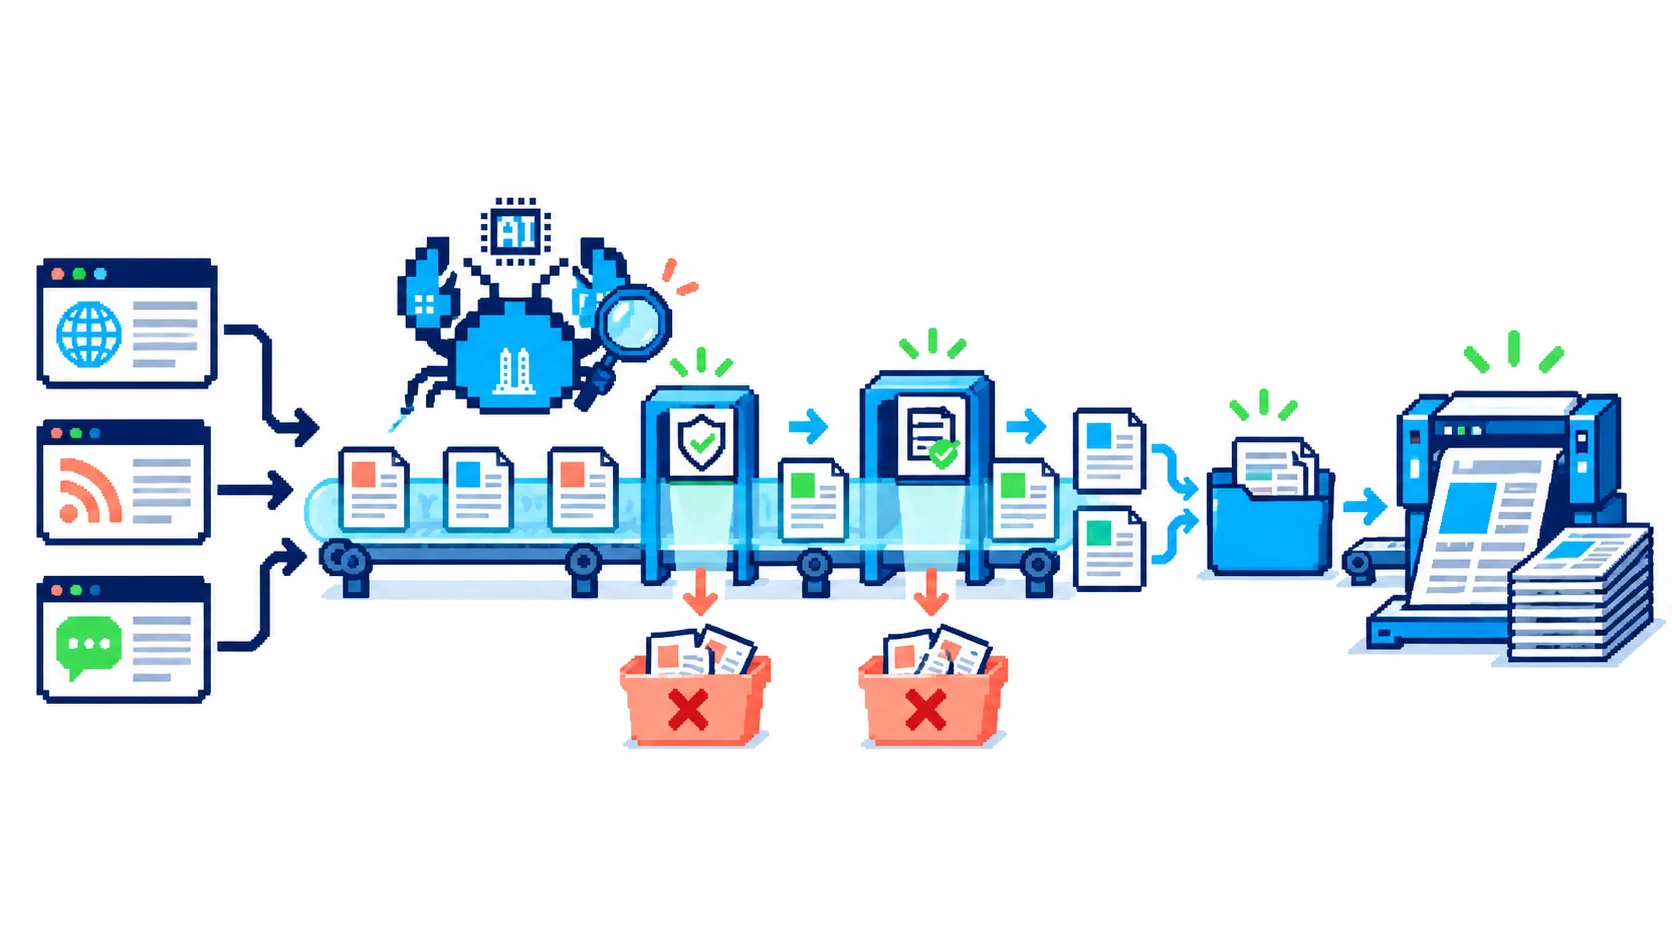
AIHOT 把采集、筛选、结构化、写作、事件归组和成刊放在一条可配置流水线里。 换信源和行业标准,就可以研究自己的资讯站;但它更像需要校准的编辑部,不是输入一堆网页就自动获得可信新闻的机器。
作者说明,公开仓库是线上引擎的导出,不能保证每次线上变化都同步;真实运营信源和一部分 AIHOT 专属功能没有包含在内。因此,开源仓库、演示站和未来 fork 的表现不能互相代替。
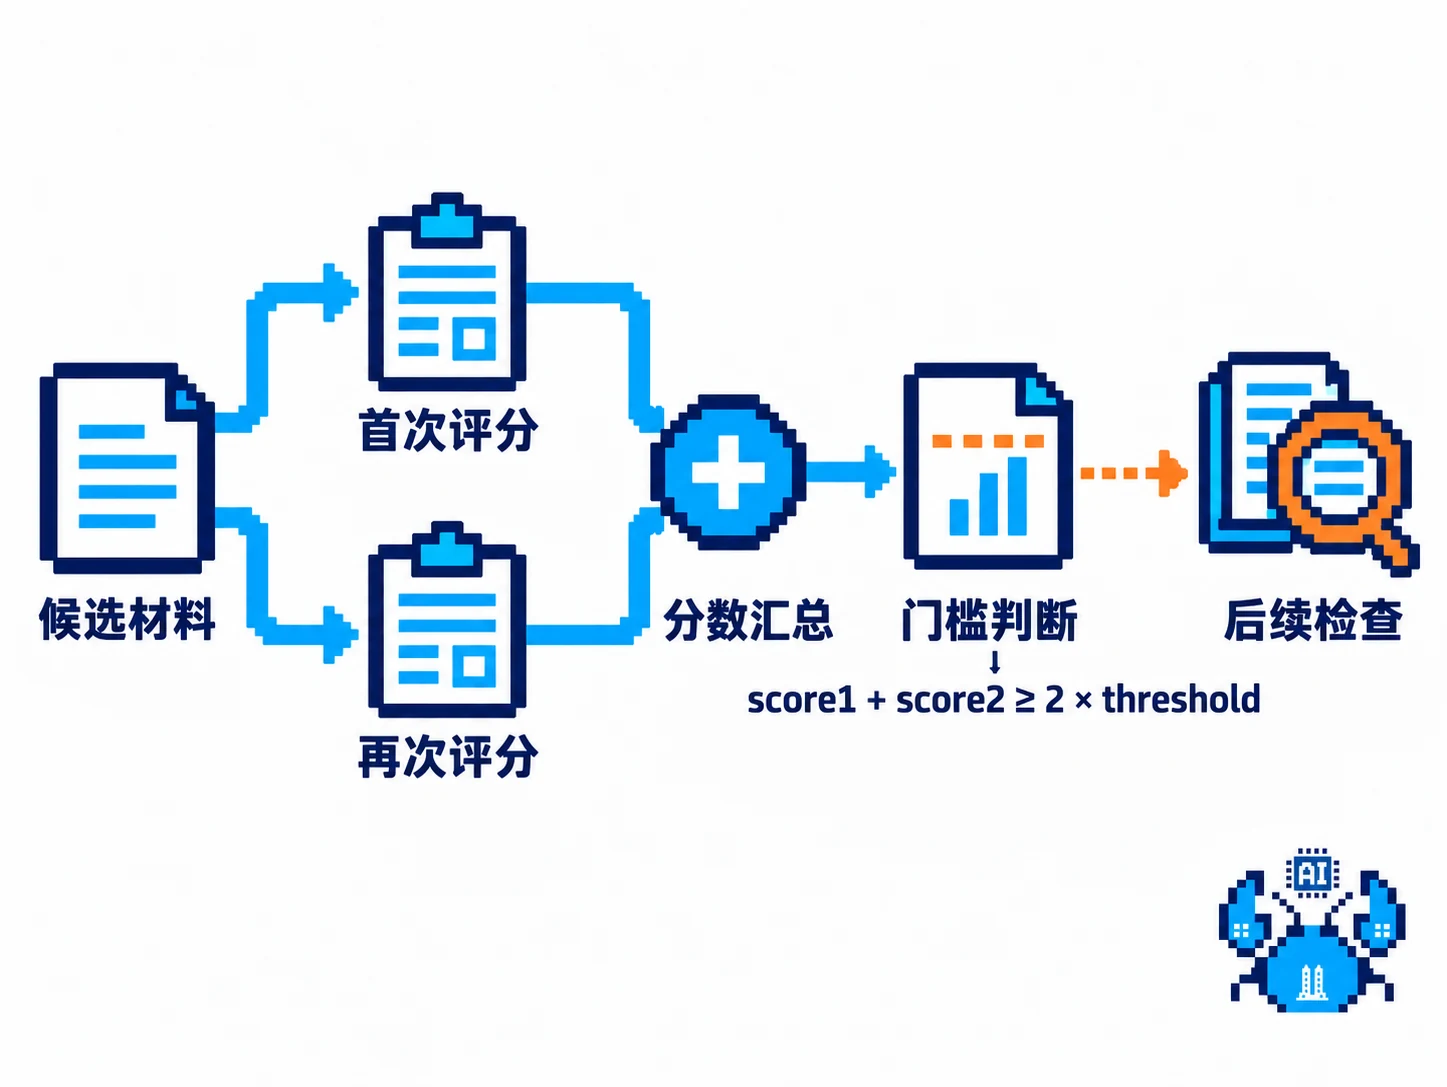
关键纠错:两次评分不是 AND 门
当前精选说明写的是:
score1 + score2 >= 2 × threshold
即两次评分的平均达到按信源分级设置的门槛;不是每次都必须分别达标,也不是取较高分。页面显示分数为平均后向下取整。原文及旧图的“两次都达标”已经不准确。
例如门槛 60 时,80 与 40 的和达到 120,满足这一分数条件;是否真正精选还要经过预筛、材料充分性及归组去重。这是说明现行规则的算例,不是模型质量实验。
“独立打两次分”是两次请求的流程安排,不保证统计独立、排除相同偏差或判断为真。应评估它是否减少了目标场景的误选和漏选,而不是把调用次数当作事实核查次数。
流程不只是六个连续盒子
- 同一网址和内容先判重;缺少可靠日期或只有标题的普通文章,按当前文档可能等待补料,不应凭空生成新闻。
- 预筛挡掉明显无关材料,评分与结构化各有职责。
- 结构化提取主体、行为、时间及原文条件;写作依赖这些材料,但提示词约束仍可能失败。
- 分数够了也要等待归组与新信息检查,不能把超时或模型失败当作自动放行。
- 日报按规则编排;周报/月报汇编既有日报,模型只参与文档指定的总述和导读,不能把所有刊物都说成整份由模型自由创作。
实际步骤和默认时间以精选与校准文档为准,不继续把“早上 8 点”当作所有部署的固定时区和必定出刊保证。
事件、热度与证据要分开
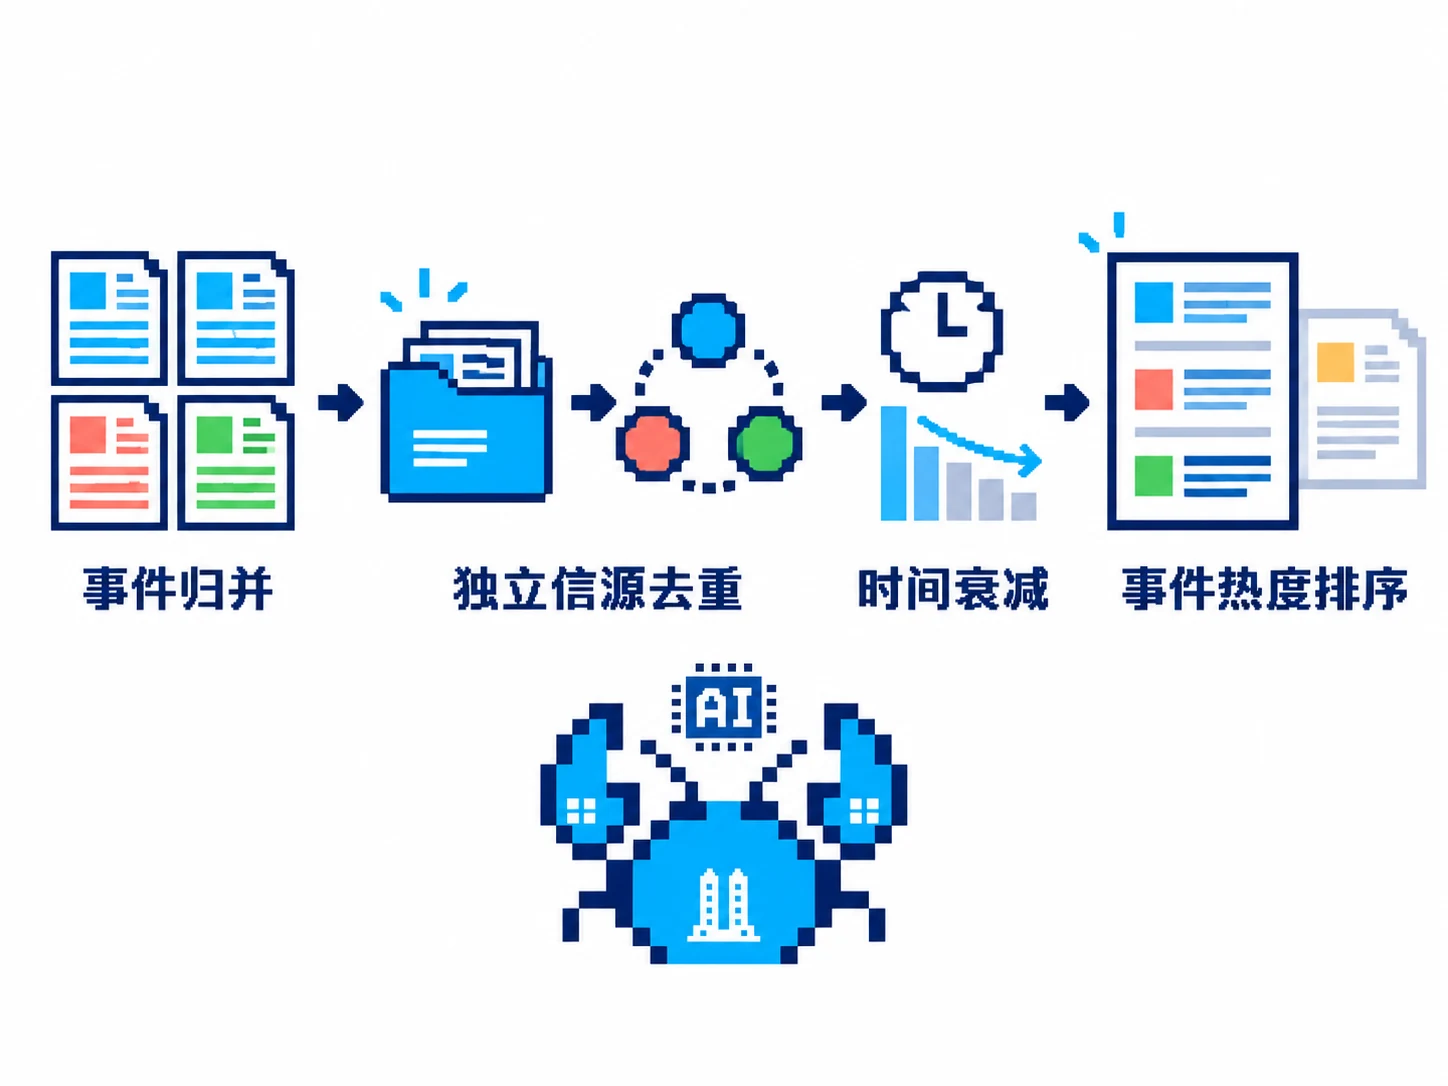
归组文档区分同一次发生、同一故事的后续、仅有关系、不同事件。候选可由向量召回,也可在未配向量服务时使用文字重合度;复核可以另配模型,不是每次都必须换一家供应商。
README 的热度规则按事件、独立来源和时间衰减计算。多个来源都报道,不等于多个独立证据都核实了事实:同源转述、通讯稿和错误转载仍会放大同一说法。热度是关注度信号,不是真实性分数,也不是金融或政策结论。
定制面现在是 site/ 与 industry/
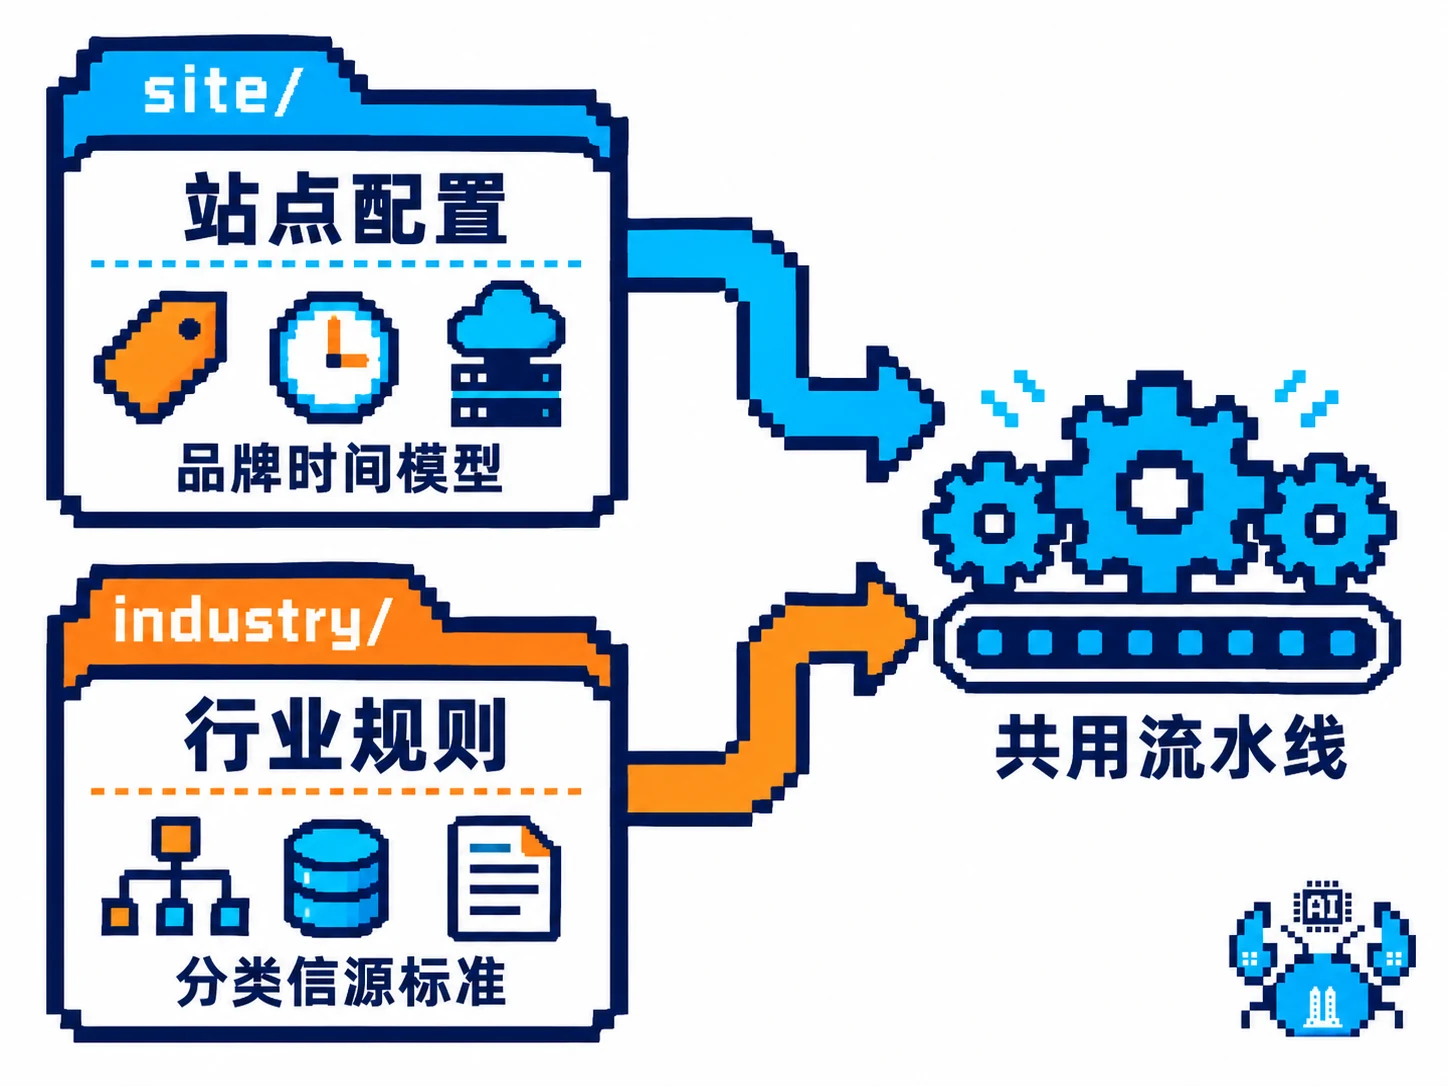
原文把 industry/ 说成唯一入口、把 industry/site.ts 当作站点配置,已过时。当前README把定制面分为:
| 位置 | 主要职责 |
|---|---|
site/site.ts |
站名、首页与关于页文案、出刊时间 |
site/models.ts |
分步骤模型默认值 |
site/brand/、site/pages/ |
品牌和站点说明 |
industry/taxonomy.ts、topics.json |
分类和主题 |
industry/sources.json |
首次启动导入的信源 |
industry/prompts/、selection.ts |
评分、写作标准与入选门槛 |
modules/ |
站点特有功能扩展 |
配置化降低一些改造成本,但定制连接器、界面或权限仍可能需要代码。“代码成为常量、完全不用改”只是比喻,不是承诺。
怎么研究与校准
先按官方部署说明准备 Node、Docker、数据库和模型配置,并安全编辑密钥;原文把真实 Key 放进 --llm-key 命令的做法可能留下 shell 历史或进程参数记录,不作为推荐安全示例。本文没有部署、消耗模型额度或跑采集。
接着选少量获准使用的信源,自行标注“该选/不该选/两可”,区分开发集与留出集。看查准率、查全率和覆盖率,还要把模型失败算入完整准确率;不能只展示成功输出的高分。归组评测另有关系样本集,不与选稿准确率混算。
公开评测工具的存在不等于本次已经运行;README 中页面毫秒数字是作者特定部署口径,不是一般页面加载速度或本站 fork 的性能保证。
数据、品牌与发布边界
代码 LICENSE为 MIT,需保留相应通知。它不授予新闻全文、图片、第三方信源、AIHOT 名称或 Logo 的使用权;作者也明确要求更换品牌。
采集和自动写作涉及平台规则、个人信息、材料版权及错误传播。即使只在团队内部使用,也不能先宣布“合规没问题”。对外公开前,逐项确认来源、授权、事实、引用和实际业务要求,必要时由专业人员判断。
保险例子应读当前监管机构等官方发布渠道;不能把已变更的机构名或未经核实的“裁判文书网 RSS”当作可直接接入接口。技术、地方政策、金融等场景都要按各自权威来源校准,不用统一提示词替代专业判断。
一句话总结:最值得借鉴的是把选稿标准、来源和评测显式化;自动化加快的是处理流程,不是自动取得真实性、转载授权或发布资质。
本次资料核对覆盖官方 README、精选、归组和许可证;未验证线上服务、采集结果、完整预算熔断或模型效果。