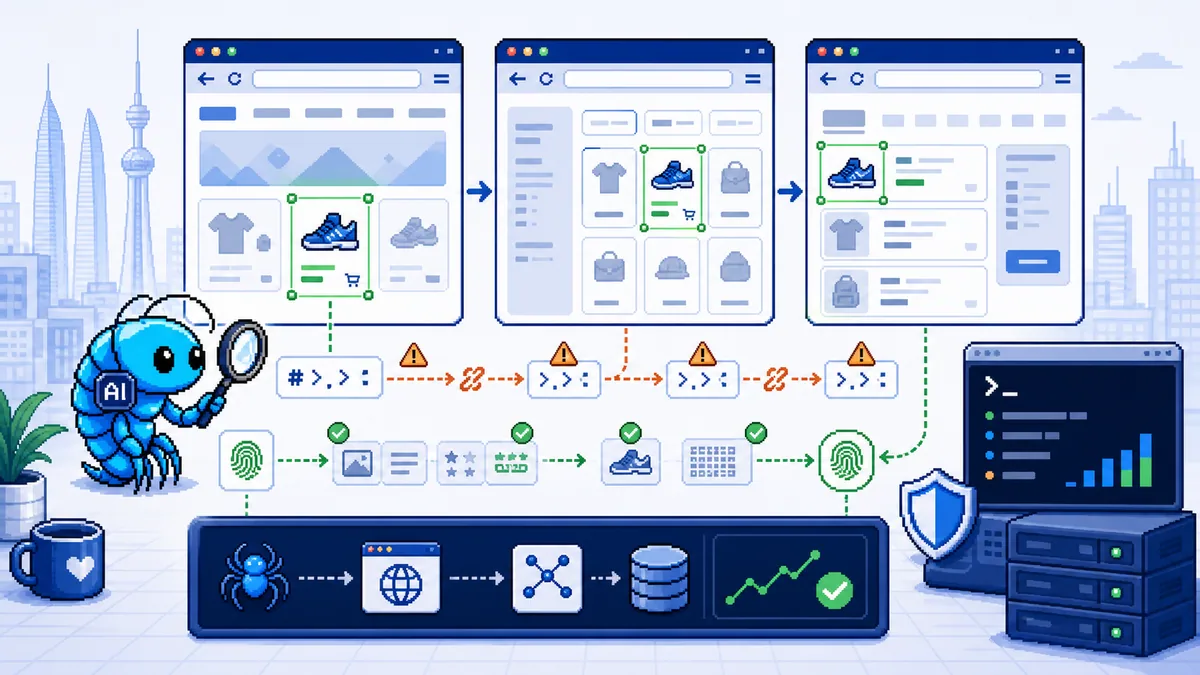
GitHub: D4Vinci/Scrapling 作者: D4Vinci License: BSD-3-Clause 语言: Python 定位: 从单次请求到 Spider 管道的自适应 Web 抓取框架
这是什么
它是一个想减少“网站一改版,爬虫就失灵”的框架。 自适应选择器会利用之前保存的元素特征尝试重新定位,不是认出了一个永远不变的“元素本人”。同类卡片、广告插入或语义变化,都可能让相似度匹配找错目标。
这个痛点值得解决;但 star 数不能证明匹配准确率,更不能替代目标站改版后的数据回归检查。
它怎么转
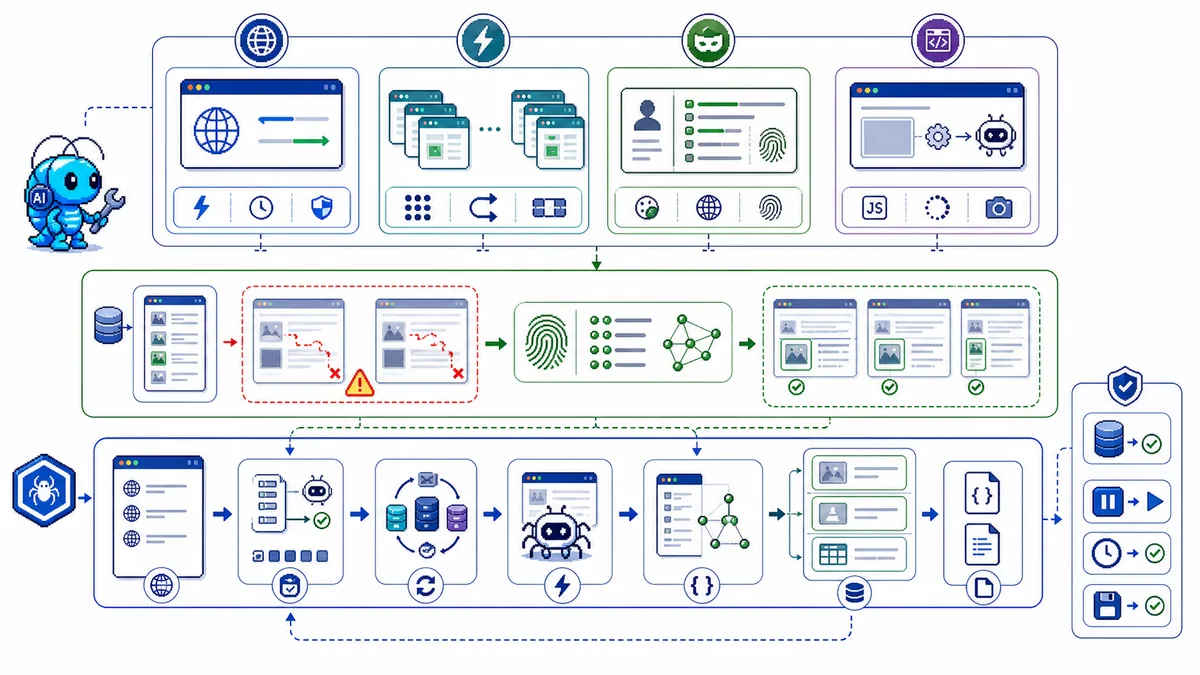
按官方 README区分几层:
触发层: 单次取数、页面结构变化、需要并发和恢复的大批量任务。
核心层 - Fetchers:
- Fetcher / AsyncFetcher:同步或异步 HTTP 抓取,可配置浏览器请求特征。
- StealthyFetcher:浏览器驱动的隐身抓取路径,不是纯 HTTP 换个头就能通过所有防护。
- DynamicFetcher:处理需要浏览器执行 JavaScript 的页面。遇到 Cloudflare 5xx,不能据此断言必须改用它,也不能保证改了就能通过。
核心层 - Spiders: 用 Spider、调度队列、去重、代理配置和流式输出组织任务;设置 crawldir 后可使用检查点恢复。恢复目录需可写,任务逻辑和数据去重也要适配重启。
输出层: Selector 的 CSS/XPath 链式提取,以及 JSON/JSONL 等导出。成功拿到 HTML,不等于业务字段已经正确。
自适应要先有基线。 官方示例先开启 StealthyFetcher.adaptive = True,再以 page.css(".product", auto_save=True) 保存元素,改版后用 adaptive=True 尝试找回。两参数并非一混用就必然错误;更实际的问题是保存策略、特征库维护,以及重定位后的字段和语义验证。
怎么升级
入门段: 先在获准访问的测试页上跑通普通 Fetcher 与选择器,再保存基线、改动页面,检查它是否仍找对商品、标题或价格。别把“返回了元素”当成测试通过。
进阶段: 根据页面是否需要 JS 选择抓取路径;记录状态码、重试与限速,给自适应结果加字段类型、唯一标识和抽样比对。
高手段: 把 checkpoint、代理、并发、streaming 和告警接成管道。对 robots_txt_obey 等选项显式配置,不假设框架自动替你完成访问策略审查。
能用在哪
- 价格或产品信息监控:适合研究结构变化时的维护成本,但价格错配要能报警,不能静默入库。
- 授权语料整理:流式处理方便接数据管道;抓取权限、再利用范围与数据质量仍要分别确认。
- 公开信息追踪:优先官方 API、RSS 或允许的抓取入口,配合每域限速和失败停止规则。
风险提示
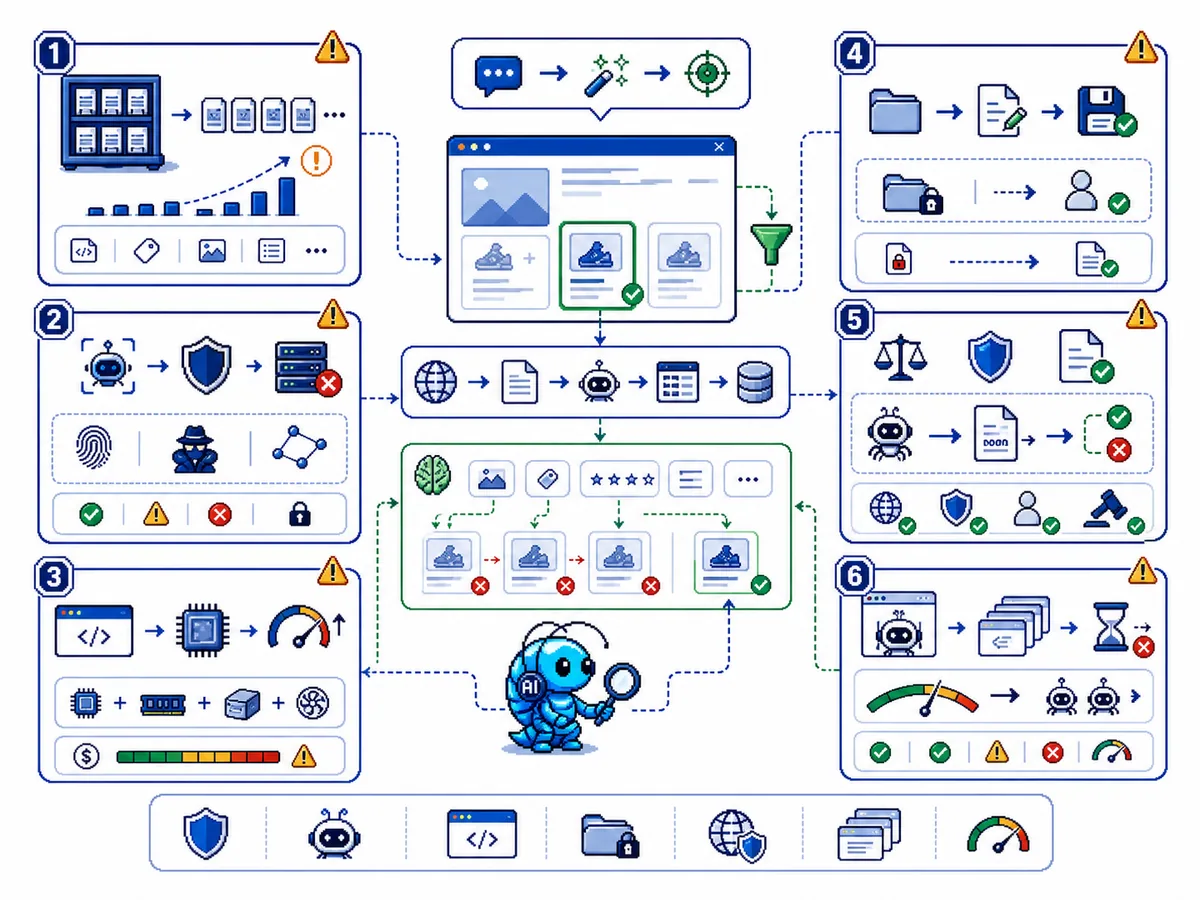
隐身、TLS 特征和代理轮换只是技术能力,不产生目标网站的授权,也不能把登录、付费或访问限制变成可以任意绕过的边界。按访问权限和用途检查站点条款、个人数据、版权与再分发限制;遵守 robots.txt 也不等于取得所有使用许可。
浏览器路径更耗资源,实际并发取决于页面和机器。Cookies、代理及导出数据都可能敏感;若再接远端模型或外部代理,另行核对哪些内容会外发。
核心洞察: 不只记元素的位置,而是给重定位多一些特征线索,这是有价值的维护思路;“尝试找回 + 验证结果”比“改版也绝不会坏”更贴近工程现实。
资料核对:2026-10-13,读取官方 README 与许可证修订;未安装运行,未测试反爬通过率、自适应准确率或吞吐。