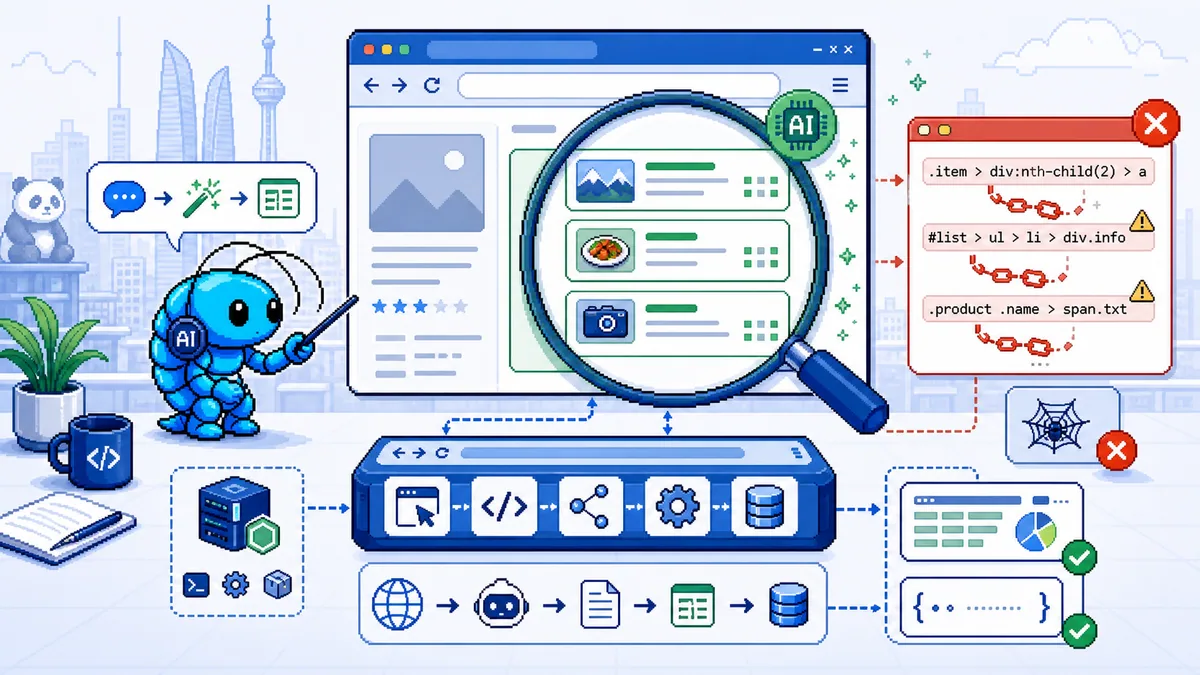
GitHub: coder-hxl/x-crawl 作者: coder-hxl License: MIT 语言: TypeScript / Node.js 定位: 基础抓取与可选 AI 解析组合的 Node.js 库
这是什么
它像一个会读网页的实习生,但还需要有人划定材料和验收标准。 基础层负责请求与浏览器操作,AI 层可以按自然语言要求分析 HTML、提取元素或建议选择器。页面改版时,这种组合可能减少手改规则的工作量;语义不变也不能保证每次都抽对。
我更看重它的组合方式:能用规则解决的先用规则,结构不稳定或解释成本高的部分再交给模型,而不是把所有页面一股脑塞进提示词。
它怎么转
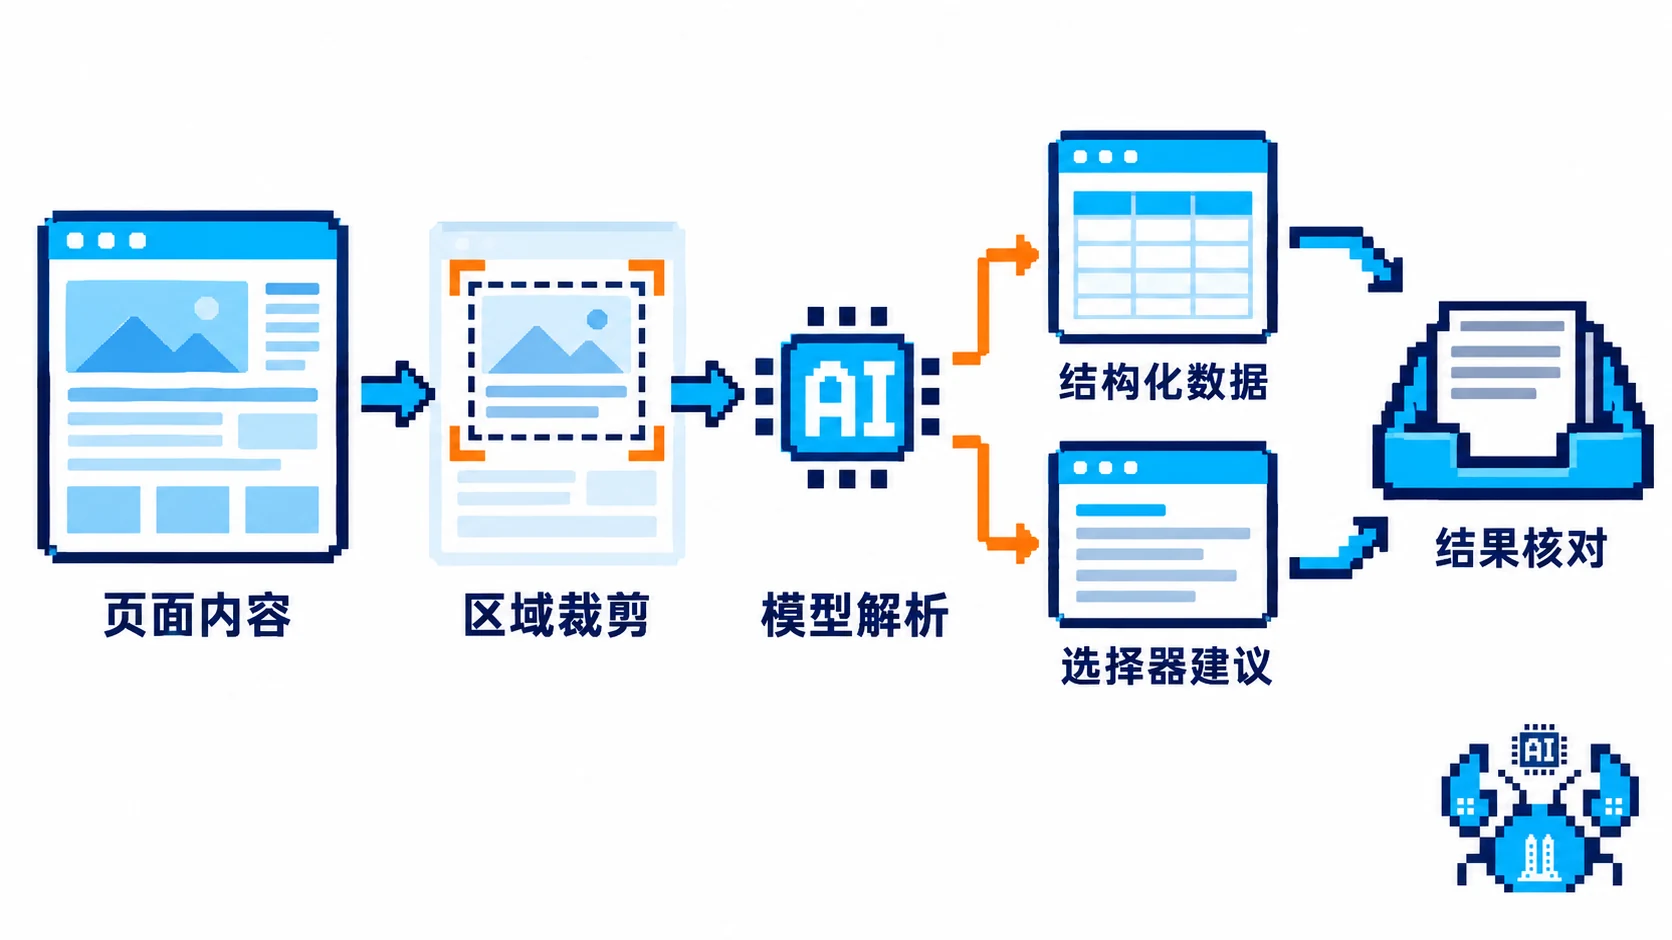
触发层: 需要 Node.js 生态的 HTTP/动态页面抓取,或需要模型辅助理解选定区域。
核心层 - Crawler(AI 非必须):
- 当前 API提供 createCrawlPage、createCrawlHTML、createCrawlData、createCrawlFile 等工厂。
- 对应页面浏览器操作、静态 HTML、接口数据和文件请求,不宜把它们都归为 crawlPage。
- 原文 crawlLinks() 未见于已读取的当前公开 API,整站遍历要自行组织链接发现、范围和去重。
核心层 - AI: OpenAI 适配源码中,createCrawlOpenAI() 返回 parseElements()、getElementSelectors()、help() 和底层客户端入口 custom()。原文的 generateCode()、ask() 不能继续当作现成方法照抄。项目另提供 Ollama 接入,但本地/远端模型是否适合任务,要按实际模型和语料比较。
工程特性: 配置并发、间隔、代理、优先级和失败重试。设备特征调整不等于无法识别或追踪,更不产生绕过目标限制的授权。
卡点层:
- 云模型解析会把选定 HTML 和指令发往所配置的服务,可能带出个人信息或内部页面内容。
- 浏览器路径需要可用的浏览器及系统依赖,不能只看 npm 安装成功。
- JSON 能解析,不代表字段语义正确;应做 schema、来源和业务规则检查。
- 当前根 package.json的 Node engines 为 >=24.16.0。按所安装版本核对要求,不把旧文发布日期当成最新兼容性依据。
怎么升级
入门段: 对照官方 README先跑不带 AI 的基础请求,区分静态页、接口和浏览器场景,记录失败行为。
进阶段: 官方 AI 示例仍先用选择器等待并裁剪页面,再调用 parseElements。这既减少无关内容和输入成本,也让输出更容易核对。选择器与自然语言是互补关系。
高手段: 接入固定任务集,比较规则、本地模型和云模型的正确率、延迟、成本与改版恢复能力;给重试、并发和外发内容设边界。
能用在哪
- 产品或房源信息整理:用规则预筛、模型辅助抽取,再按 URL/业务 ID 去重。模型解析本身不是自动去重的保证。
- 图片链接筛选:先取候选和上下文,再做语义分类;另行确认图片获取、存储和再使用权限。
- 公开信息监控:优先稳定 API、RSS 和可用规则。复杂页面可以试 AI 辅助,但不是政务/媒体网站“唯一靠谱”的方案。
风险提示
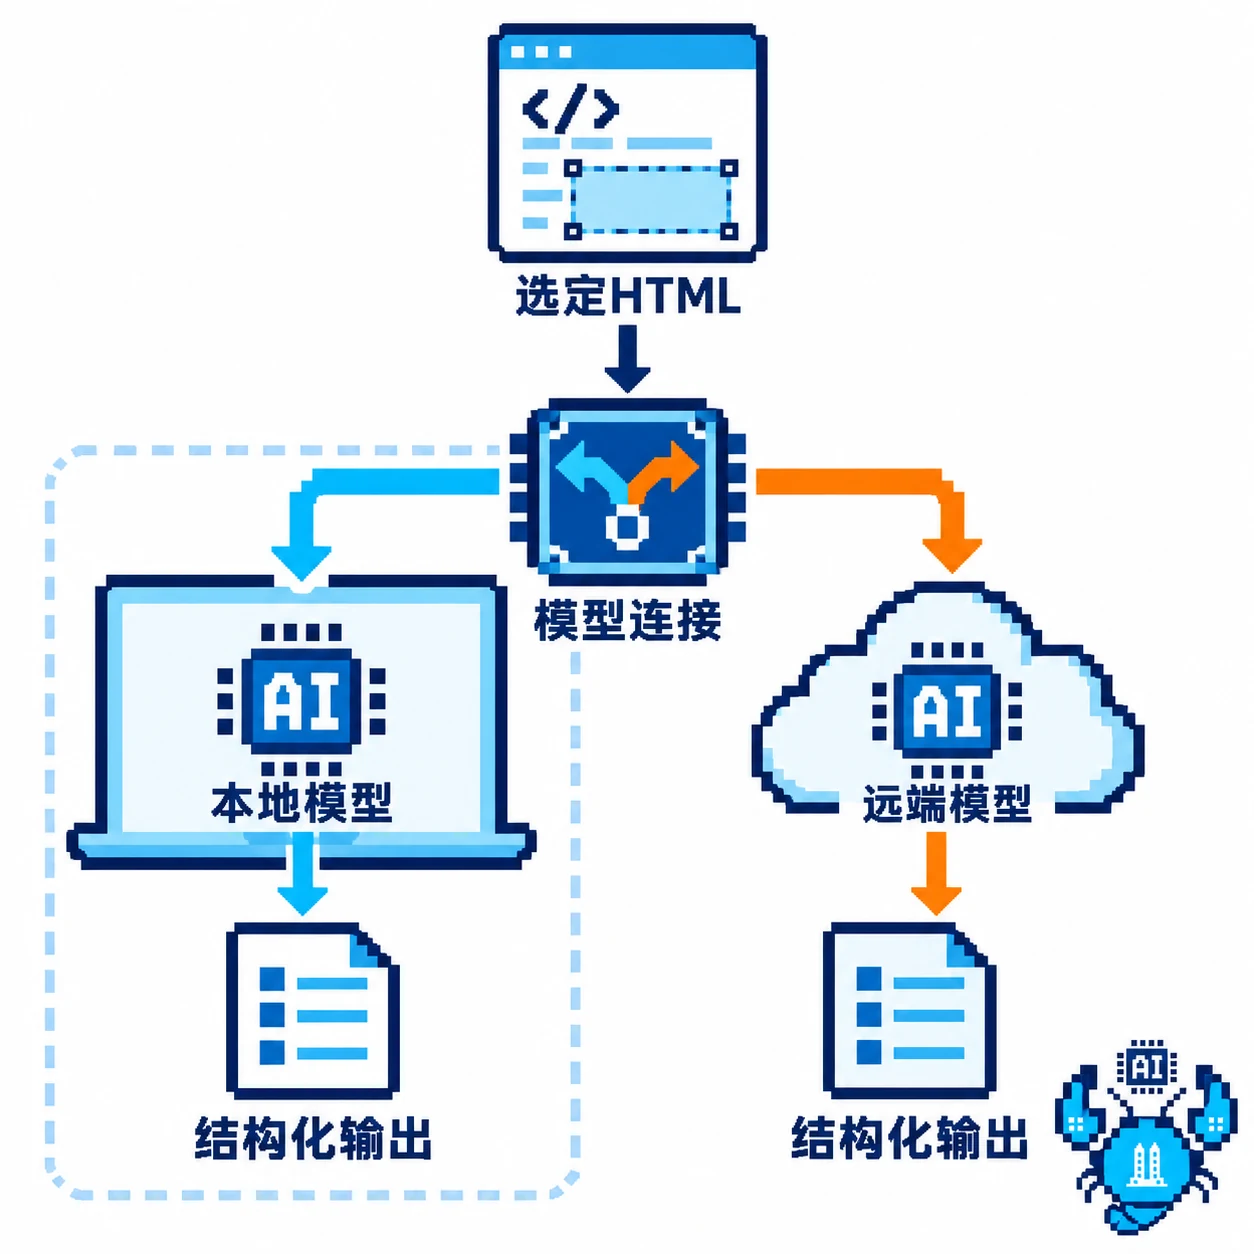
HTML 输入可能包含提示注入内容,只把它当作待提取数据,不授予页面文字执行命令或调用其他工具的权限。保护 Cookies、代理凭证和输出文件;本地 Ollama 也要检查是否仍接了远端抓取、日志或其他服务。
反爬技术、抓到数据、获得再分发许可是三件事。MIT 许可覆盖项目软件,不覆盖被采集网页、模型服务或第三方数据的使用权。
核心洞察: 爬虫的长期成本往往在“改”。x-crawl 提供了规则抓取与语义解析的组合工具,但真正可维护的管道仍靠范围裁剪、结果验证和失败处理。
资料核对:2026-10-13,读取官方 README、抓取/AI 源码、package.json 与许可证;未安装运行,未比较模型效果、费用或反爬表现。