Agent 实践
x-crawl:AI 辅助的 Node.js 爬虫框架 / 项目研究报告
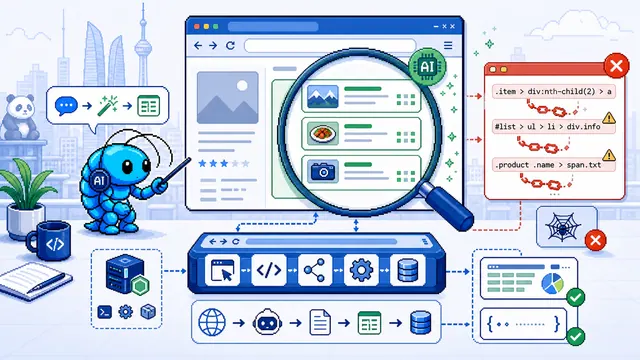
x crawl 项目研究报告 GitHub: coder hxl/x crawl 作者: coder hxl License: MIT 语言: TypeScript / Node.js 定位: 基础抓取与可选 AI 解析组合的 Node.js 库 这是什么 它像一个会读网页的实习生,但还需要有人划定材料和验收标准。 基础层负责请求与浏览器…
Research notes
不是项目说明书,而是读完、跑过、拆开以后留下的判断。
x crawl 项目研究报告 GitHub: coder hxl/x crawl 作者: coder hxl License: MIT 语言: TypeScript / Node.js 定位: 基础抓取与可选 AI 解析组合的 Node.js 库 这是什么 它像一个会读网页的实习生,但还需要有人划定材料和验收标准。 基础层负责请求与浏览器…
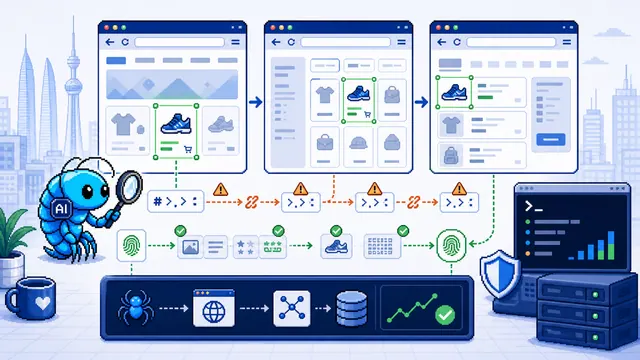
Scrapling 项目研究报告 GitHub: D4Vinci/Scrapling 作者: D4Vinci License: BSD 3 Clause 语言: Python 定位: 从单次请求到 Spider 管道的自适应 Web 抓取框架 这是什么 它是一个想减少“网站一改版,爬虫就失灵”的框架。 自适应选择器会利用之前保存的元素特征…