原研究日期:2026-09-18;资料核对:2026-10-13。项目:browser-use/jev-ultrafast。 下面的性能数字来自作者公开记录,不是本站复测。
一句话定性
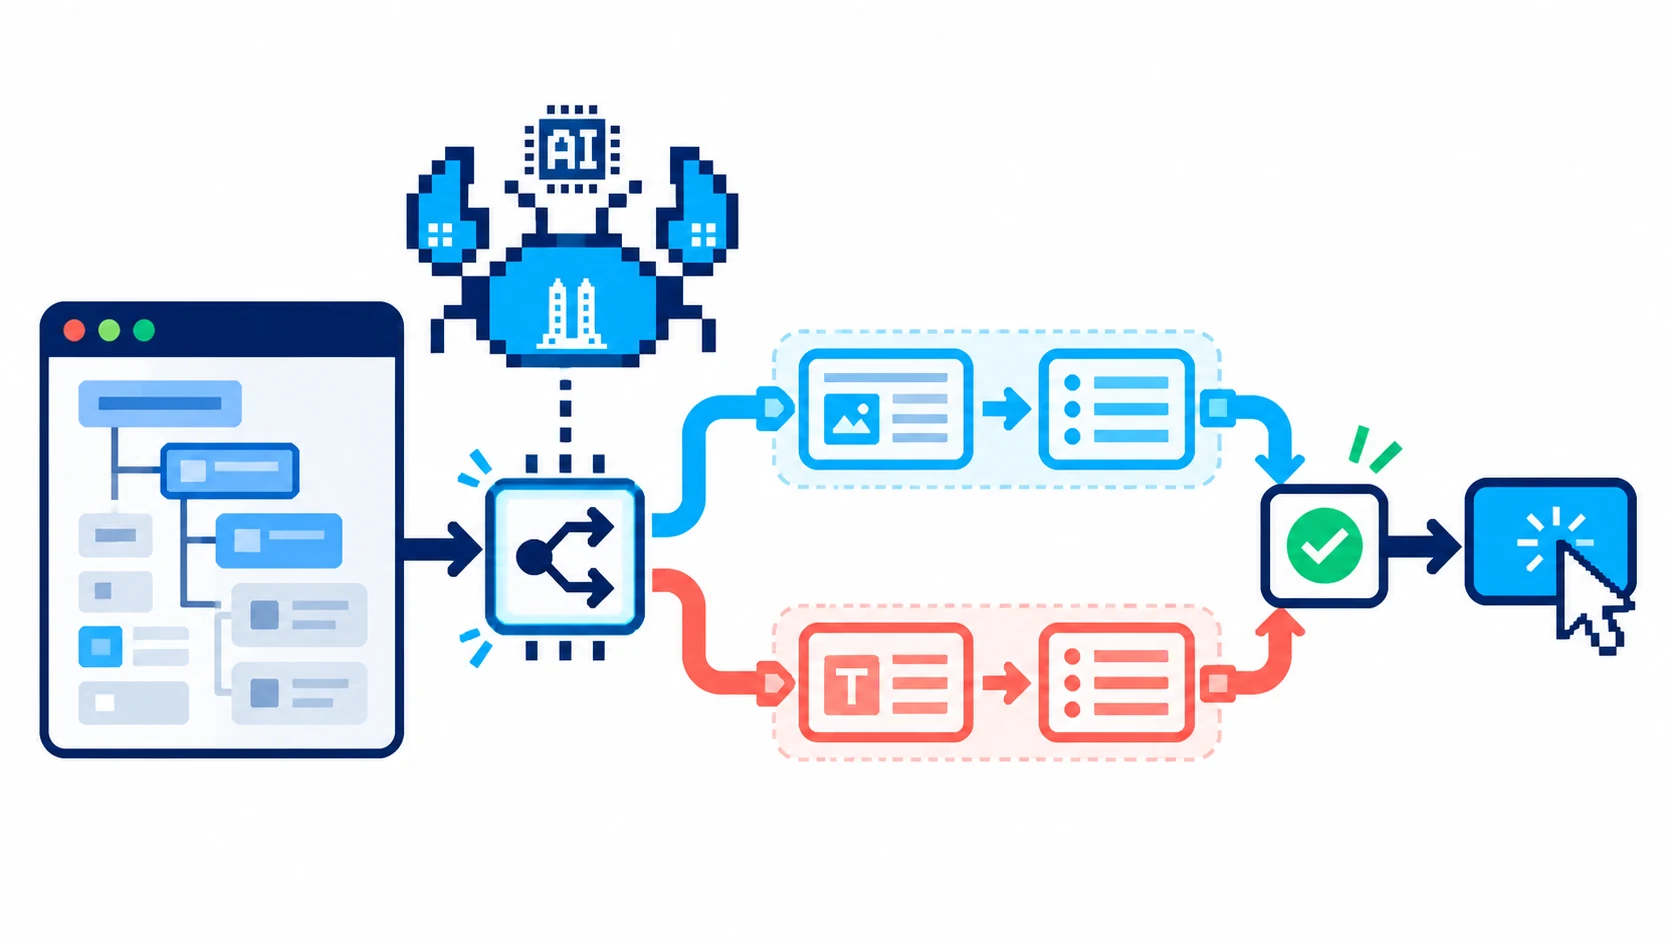
它把浏览器操作和目标选择放进同一次 TypeSafe 请求,并用结构化页面状态减少重复浏览器工作。 像先看一张当前控件清单,再同时问“做什么、对谁做”,不是把所有动作都交给一段自由生成的脚本。
原稿的“2026 年最快”“性能 SOTA”“省 90% LLM 调用”和“视觉 token 贵 100 倍”都没有足够证据,本次撤回。项目在 browser-use 组织下,不能据此把对照实验写成对主项目或整个行业的胜利。
它怎么转
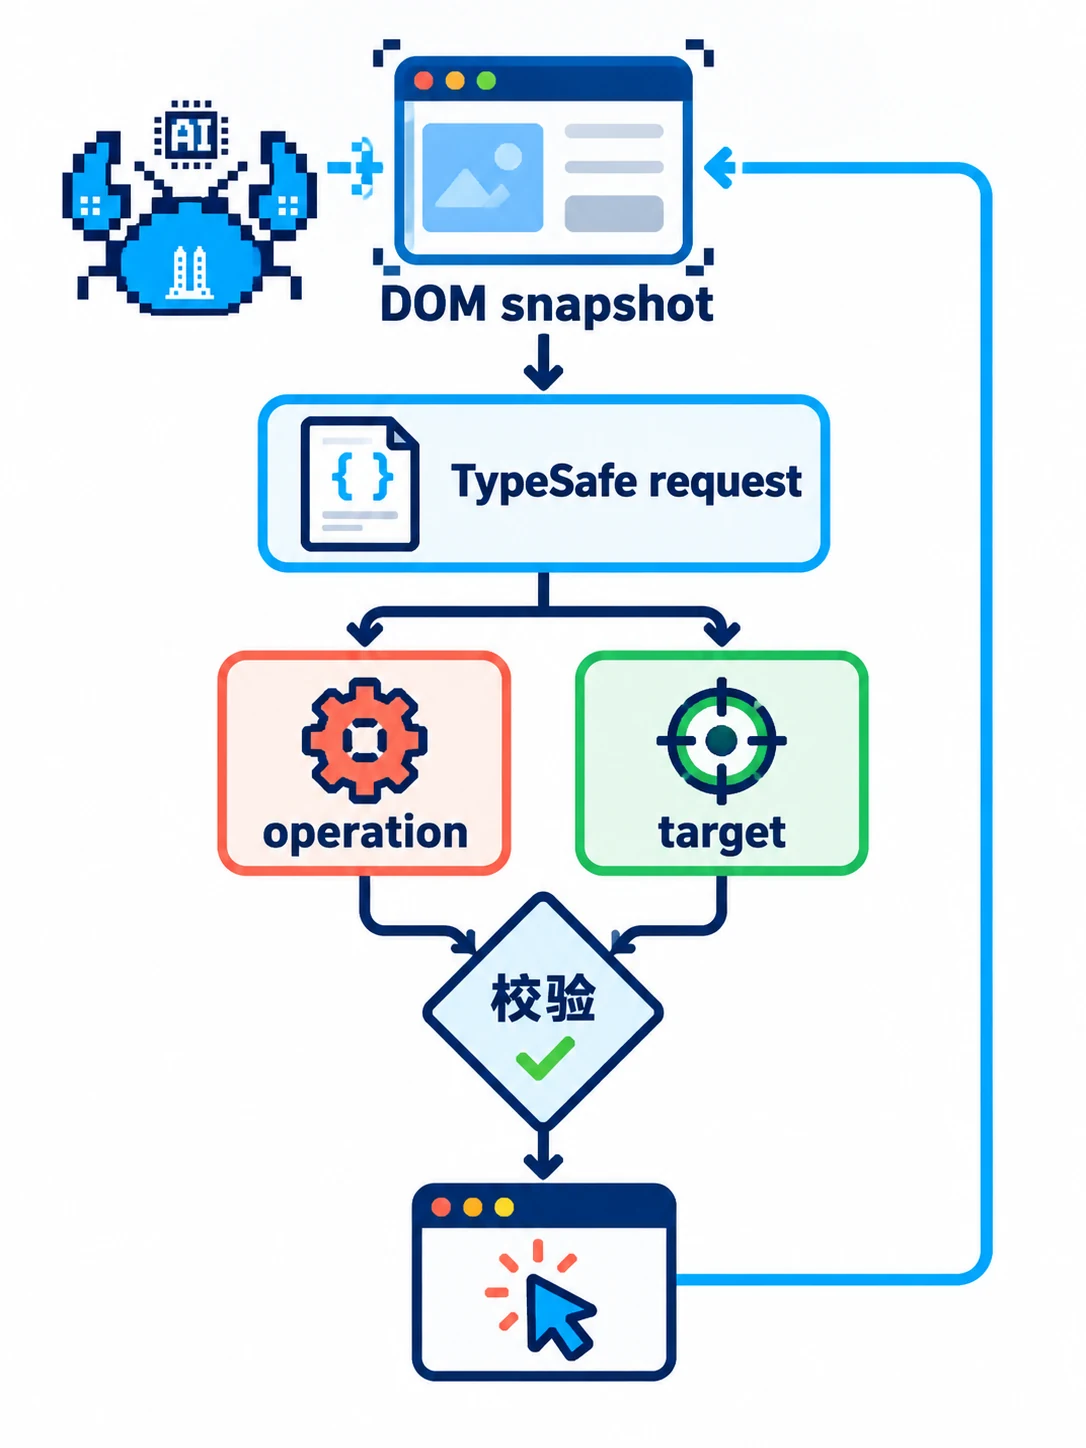
一次观察产生动态元素表。一次 TypeSafe 请求提出操作与兼容目标的候选问题,执行器只采用与最终操作匹配的目标;这就是这里的推测式 fan-out,不是所有分支都会执行,也不是每条任务只调用一次模型。
动作集合包括点击、输入文本、下拉选择、滚动、等待、完成与受阻等。索引对应当前观察到的 DOM 节点,不是永久定位符。
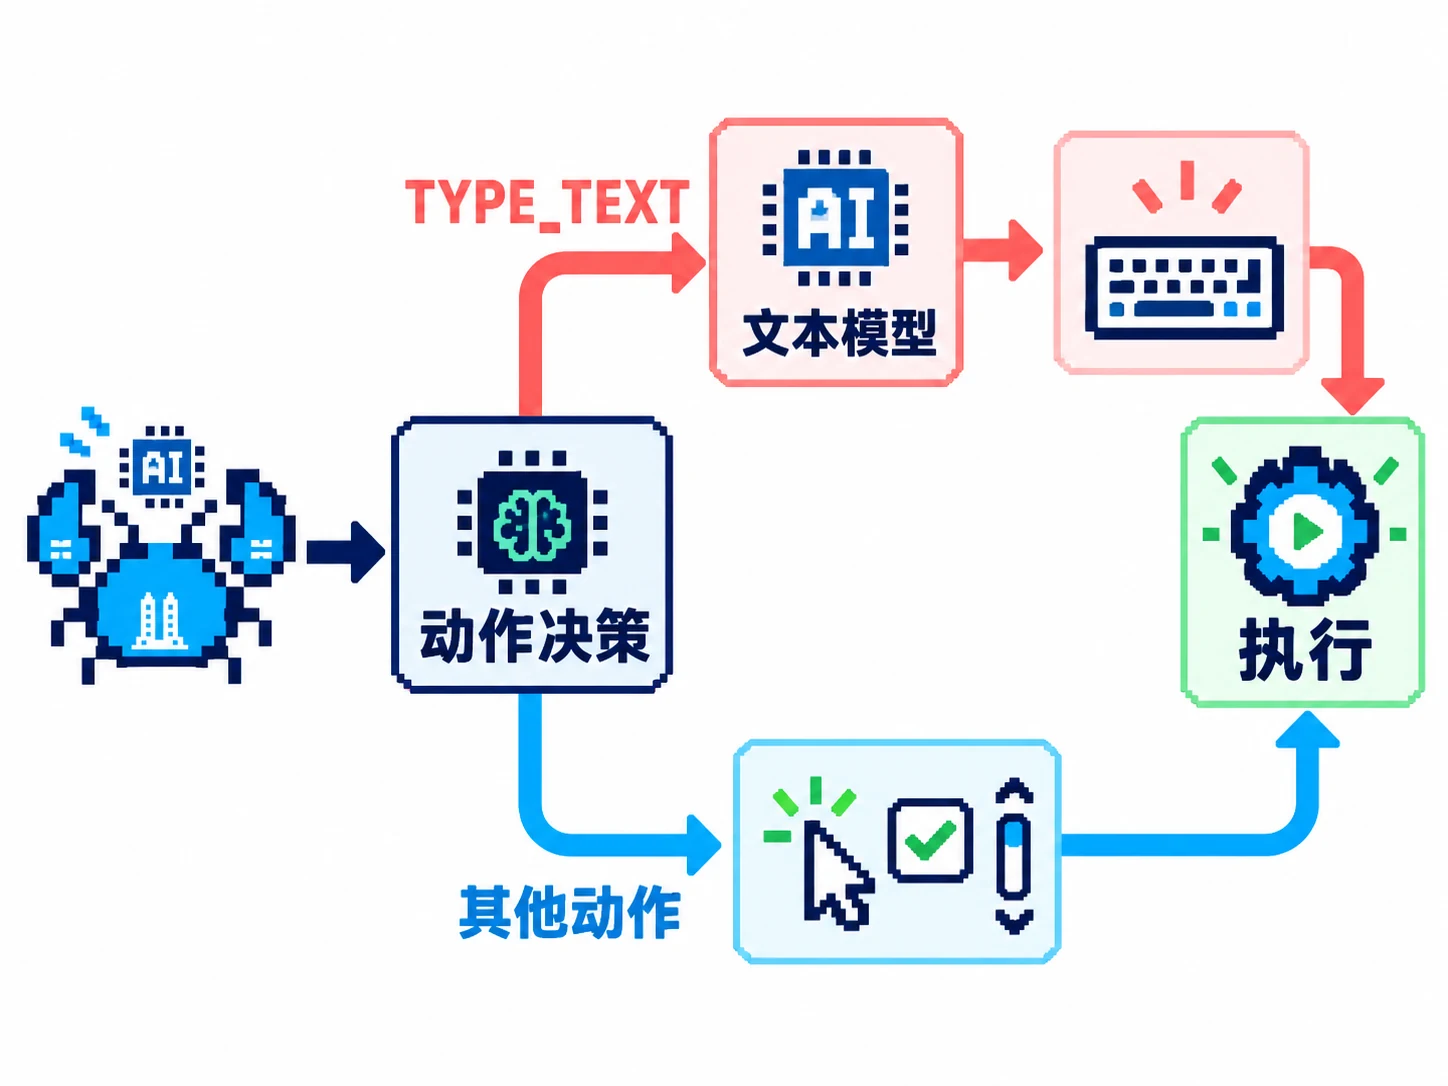
每个决策周期仍需要 TypeSafe 决策。 仅当操作是 TYPE_TEXT 时才额外调用文本模型写入内容;其他动作省去的是这层文本生成,不是省掉所有模型调用。生成文本仍可能错误或包含敏感信息,不能因为结构化 JSON 就免于核查。
默认主循环使用结构化 DOM 状态,不依赖截图;Inspector 可以选择截图。这是特定实现的输入选择,不意味着视觉任务总比文本任务贵,也不保证 DOM 能覆盖页面全部语义。官方 README。
25% 和“10 倍”到底比较了什么
performance.md记录的是同一项目旧运行时与优化运行时,不是通用 browser-use 主项目对决:
| 项目 | 作者记录的边界 |
|---|---|
| 任务 | 一个 Google Flights 搜索目标、同一个现有 Chrome profile |
| 样本 | 六次交替运行,每个版本三次,均经独立结果检查 |
| 时间中位数 | 9.450 秒 → 7.092 秒,降低约 25% |
| 浏览器协议调用中位数 | 1,092 → 101 |
| TypeSafe 请求中位数 | 22 → 17,不是 1,092 → 101 |
| 计时范围 | 从初始页面观察后的预测开始,到接受 DONE;不含浏览器准备、首次导航和独立结果复核 |
三对样本不能证明广泛统计显著性或所有网站的收益。单次展示视频的 7.073 秒与三次运行中位数 7.092 秒也不是同一个数。
浏览器协议调用、模型请求、token 和账单是四个不同指标。 少一次协议读取不等于少一次 LLM 请求。报告中的文本 helper 费用不包括 TypeSafe 费用和浏览器成本,不能拿它当完整任务价格。Wikipedia 与本地酒店样例是单独 smoke checks,不是同口径通用性能排名。
新鲜度校验与安全边界
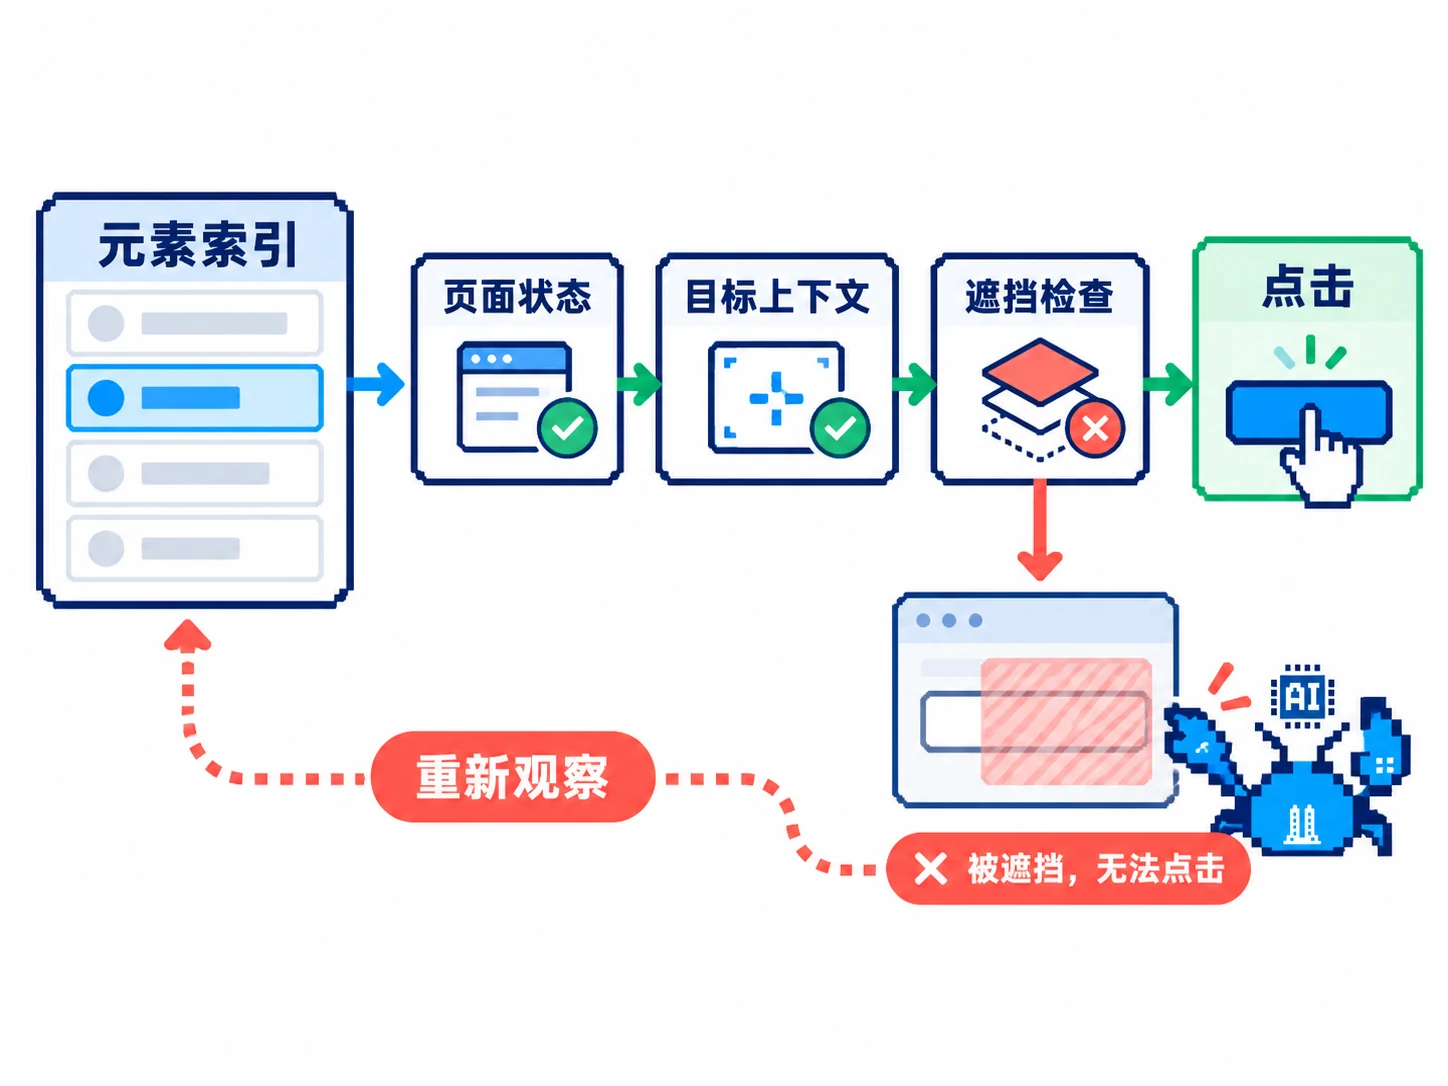
执行前检查页面、表单、目标与附近上下文,再检查当前几何和遮挡;变化不符合条件时重新观察。把模型限制为有限动作与索引目标,能减少一类自由代码执行风险,但不是 XSS、提示注入、隐私泄露或误操作的完整防护。
执行器本身仍使用浏览器脚本、协议及权限。被允许的操作也可能选错目标;DONE 是模型选择,不是任务成功证据。发送消息、付款、下单、变更账户或录入生产系统都要有独立授权及结果验收。
当前适用范围
README 把 Shadow DOM、frames、canvas、上传、新弹窗、嵌套滚动和任意键盘控件列为 MVP 范围外。DOM reader 也不实现完整 accessible-name 规范。不能推荐它全面替代 Playwright/Selenium,也不能把验证码或登录墙列为默认可绕过的测试场景。
已有 Chrome profile 会被共享使用,所以先选最小权限的测试账户,避开私人标签和生产账户。页面状态或待输入文本送往模型时,还要评估数据外发。
怎么开始研究
按官方说明准备 Chrome、Browser Harness、TypeSafe 和文本模型配置;先在本地合成页面与只读目标上尝试,不承诺几秒钟完成真实业务。
git clone https://github.com/browser-use/jev-ultrafast.git
cd jev-ultrafast
uv sync
cp .env.example .env
# 安全编辑 .env 中所需配置,不把真实 Key 放进命令历史
uv run jev
本次未执行上述命令。实时样例会调用付费模型;项目的离线测试、无模型的本地控件检查和实时任务也要分开,不把“测试通过”写成“生产网站都可靠”。
可迁移的思路:减少重复观察、对兼容目标做联合决策、只在需要时调用文本生成器。迁移到另一框架后,仍要重新测成功率、误操作、完整费用和端到端耗时,而不是沿用 25%。
一句话总结:值得借鉴的是有界决策与减少无效往返,数字只在对应任务、版本和计时边界内成立。
资料核对:读取官方 README、性能记录及模型实现;未运行浏览器任务、模型 API 或性能测试。