原研究日期:2026-09-17;资料核对:2026-10-13。研究对象:Tencent/WeKnora。 本次核对文档与许可证,没有部署实例、做权限测试或验证问答准确率。
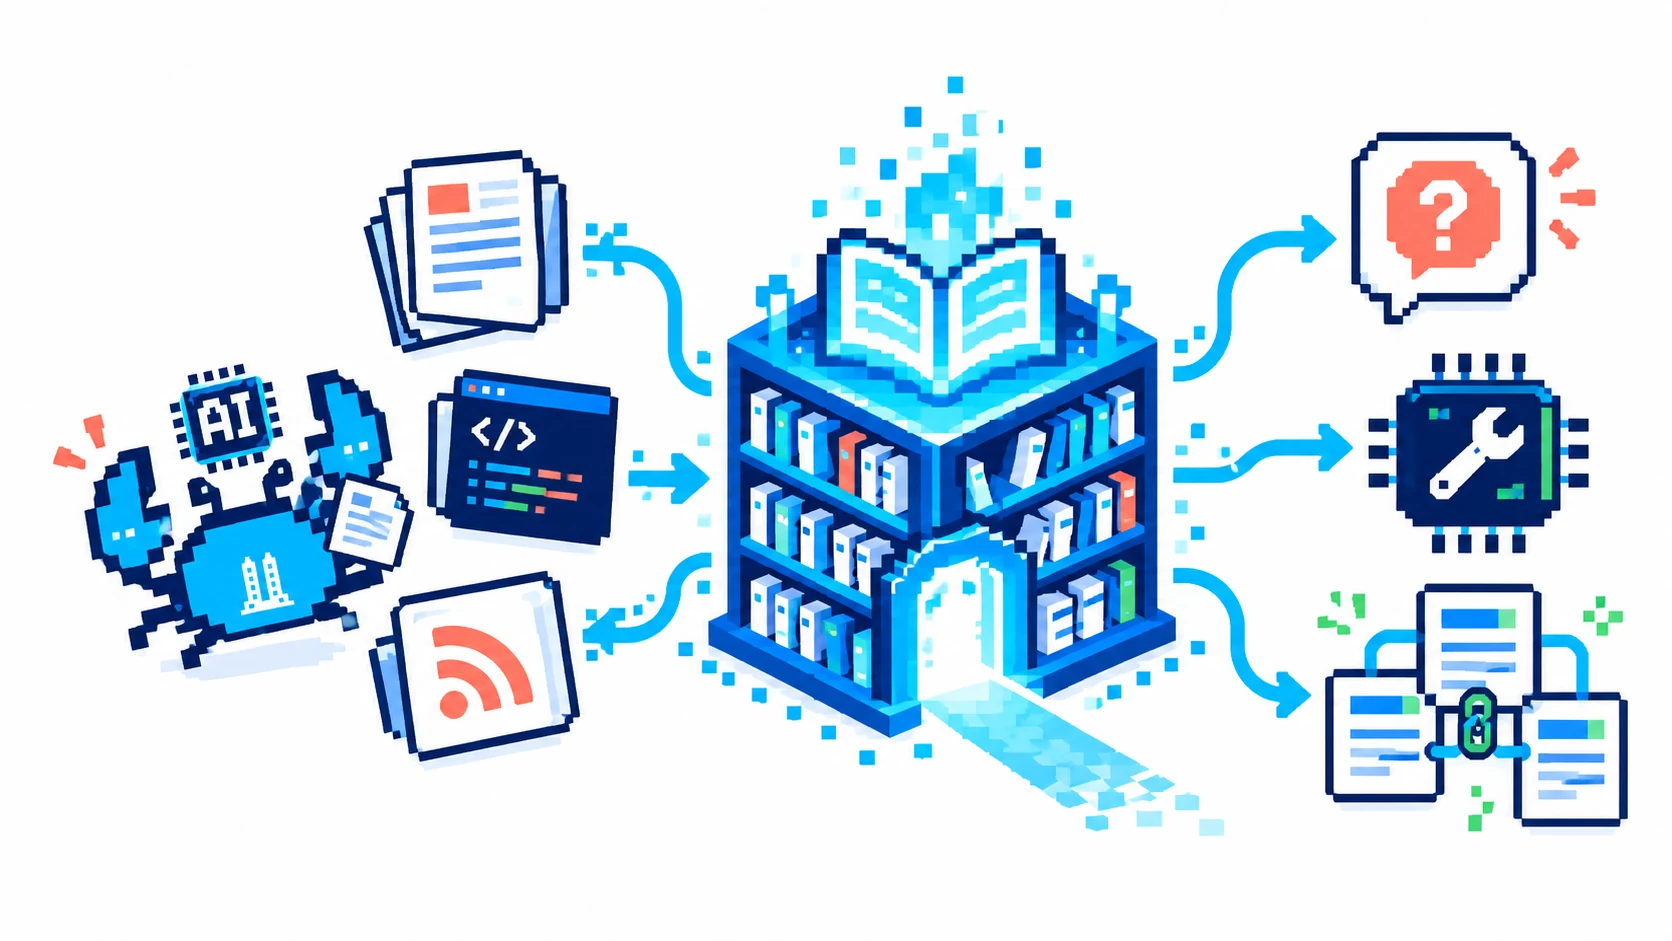
一句话定性
WeKnora 是把企业文档组织成可检索知识库,并让问答、任务型 Agent 和 Wiki 共用这份底座的框架。 它像一间有目录、借阅范围和工具台的资料室;资料收齐了,不代表每个回答都会正确,也不代表买回去就免运维。
官方组织身份有助于辨认项目来源,不能替代安全评估或服务承诺。“国内最省心”“大厂背书所以能直接全员用”是原稿没有验证依据的判断,本次撤回。
它怎么转
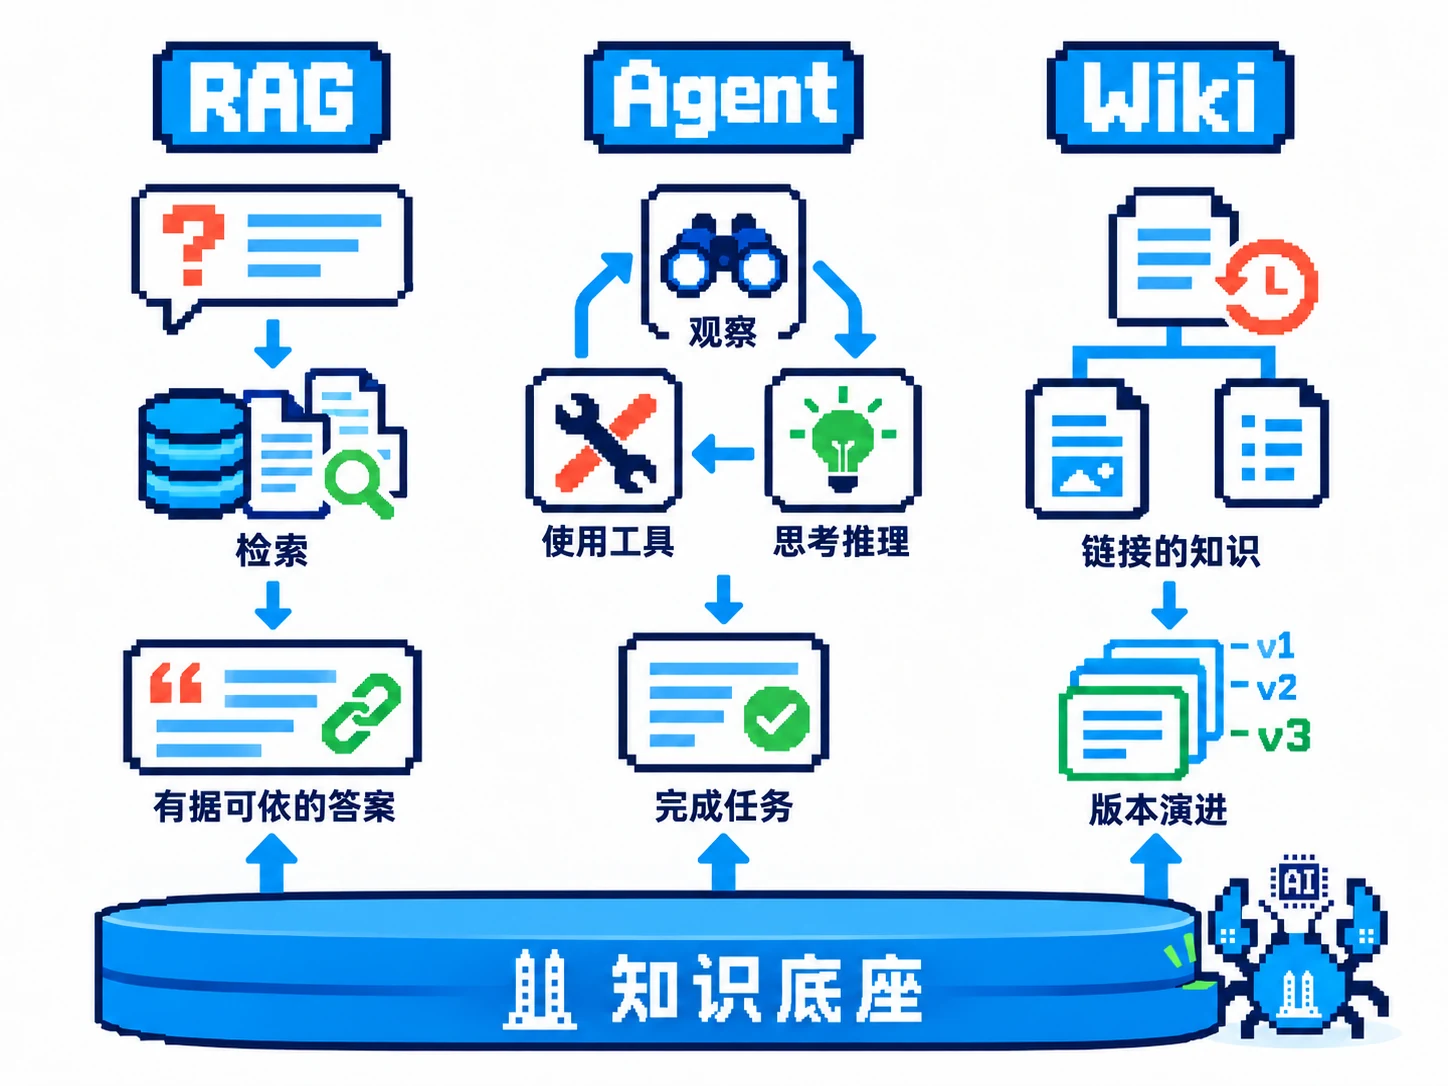
- RAG:先检索候选文档,再生成带引用的回答。引用便于回看来源,不自动证明回答与原文一致。
- Agent:把知识检索、外部工具和多步任务结合起来。每次外部读写仍应受账户权限、工具配置和人工确认约束。
- Wiki:把材料整理成相互链接的页面,配合知识图谱与版本回滚。自动整理是工作方式,不是无人值守的事实认证。
三者是不同入口,不是一条“RAG 完成后必须执行 Agent,再生成 Wiki”的串行流水线。官方概览也把它们放在同一知识底座之上。
摄取与检索
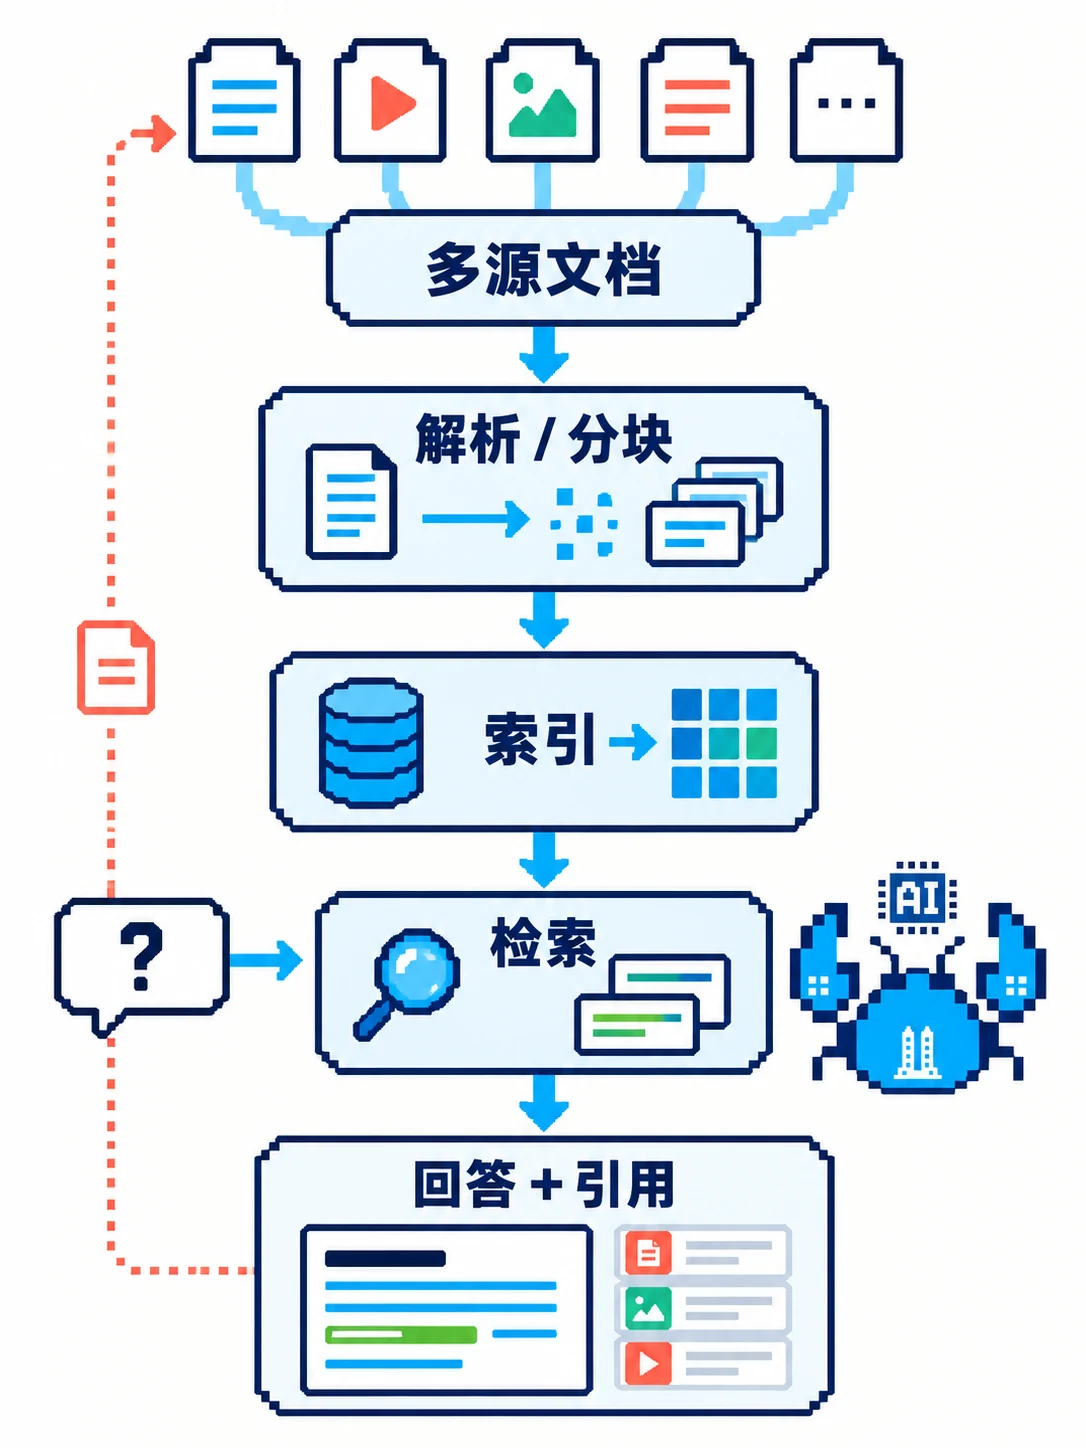
资料经过解析、分块、索引和召回,才能进入回答。扫描件识别、表格结构、分块位置、检索排序和来源更新都可能影响结果。应拿一组自己能判断对错的问题检查:漏了哪些材料、错引了哪一段、权限不足时是否仍返回了内容。
当前仓库列出多种文档格式、模型供应商、向量与存储后端,以及不同的 SaaS 和 IM 接入。列在文档中不等于所有组合都已被本文测试;实际接入还需要相应账号、权限、网络和版本条件。原稿按后端数量相乘得出“几千种配置”的做法,也不是实际兼容组合统计。
当前版本需要修正的认识
- 核对时 README 标示 v0.8.2,原文的 v0.8.0 不能继续叫“最新版本”;main 的说明与实际安装镜像仍须区分。
- 当前内置 MCP Server 按工作空间提供 Streamable HTTP 端点;README 已把旧 Python
mcp-server/标为 deprecated。旧 PyPI 包和固定“29 个工具、三种传输”不应继续当作当前默认架构。 - 标准部署、Lite 单二进制和桌面源码入口不是同一套部署方式。Lite 文档描述 SQLite 与内存队列;不能把它误写成换一个极简 env 文件就运行同一标准栈。
- README 链接 DSH 插件,是可核对的集成入口;这不等于腾讯为整个 DeepSeek Harness 生态、所有插件或所有使用方式作官方质量认证。
以上按当前 README和Lite 说明核对。动态数量、star、issue、仓库体积和逐版本功能长表已移除,避免把宣传清单或未留存快照的数据当作研究证据。
怎么开始
先选标准版还是 Lite,再按对应说明准备环境。标准 Docker Compose 的当前文档入口是:
git clone https://github.com/Tencent/WeKnora.git
cd WeKnora
cp .env.example .env
# 先审查并编辑配置、凭证、端口及目标镜像版本
docker compose pull
docker compose up -d
官方默认 Web UI 是 http://localhost,不是旧文的 localhost:3000;该端口在文档中用于可选 Langfuse。生产不要照搬默认暴露方式。应固定目标版本、备份数据并看升级说明;只运行 up -d 不一定更新已缓存镜像。本文没有执行这些命令,也不承诺 30 分钟完成部署。
进阶动作:只导入少量获准使用的材料,建立正确答案和禁止访问样例;先验检索与引用,再接 IM、Wiki 和外部工具。扩展一项就复测一项,不把连接器数量当作完成度。
权限、沙箱与数据流
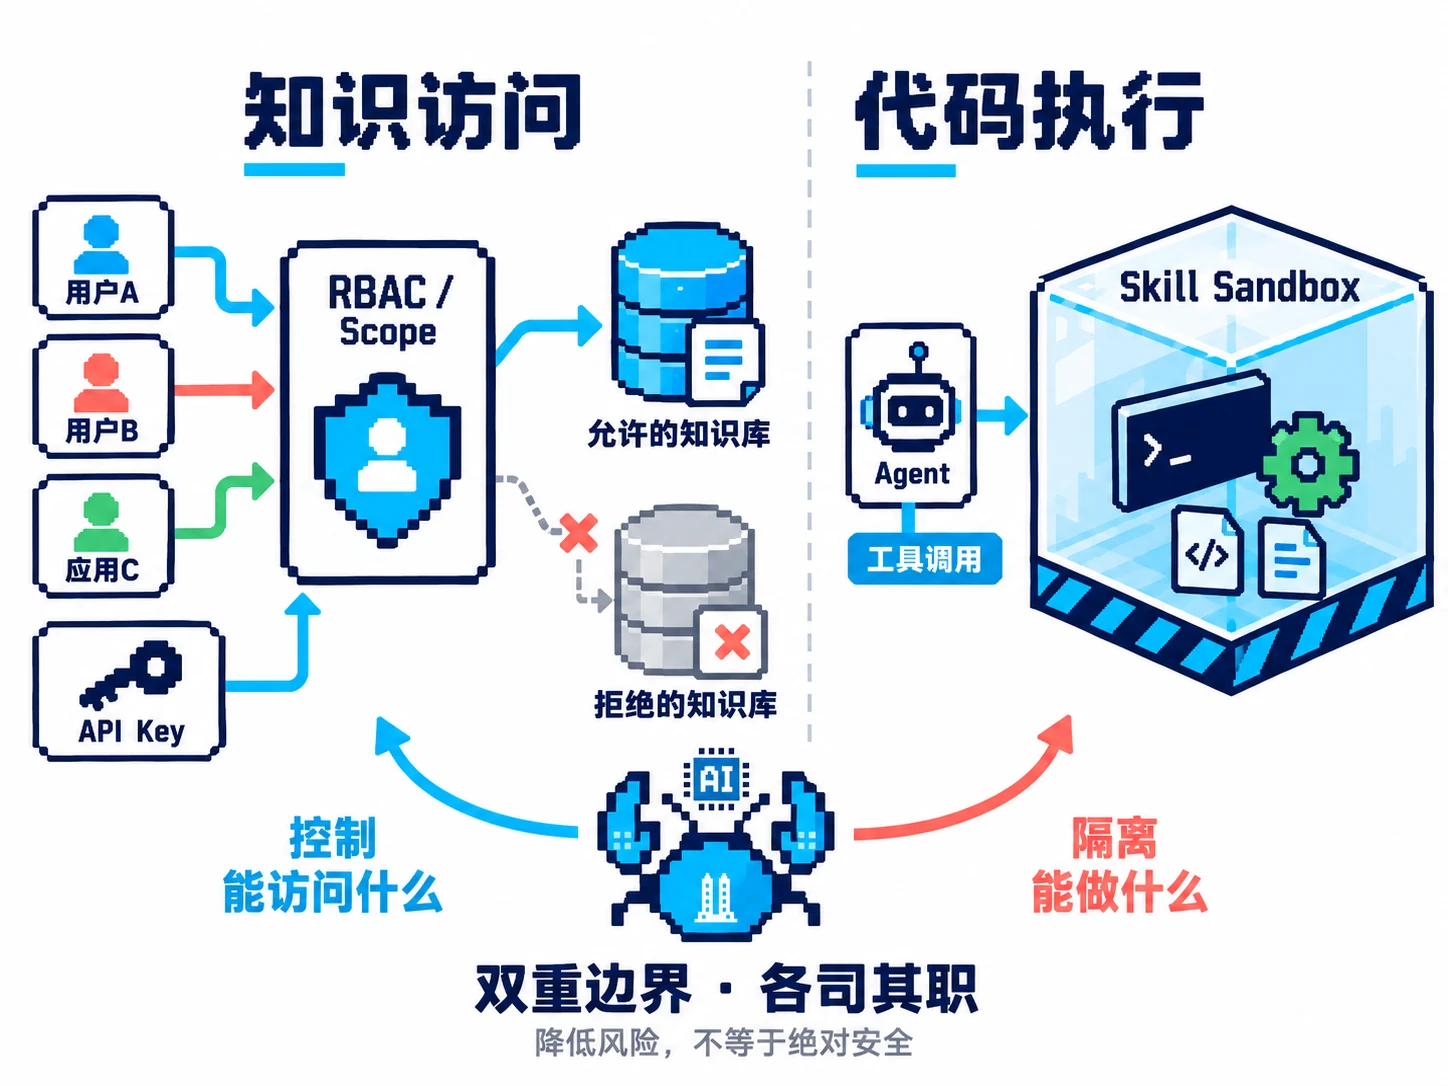
RBAC、资源归属、Scoped Key 和沙箱各管一层,不能合成“企业级所以绝对安全”的结论。需要检查跨工作空间访问、撤销权限后的检索、过期索引、公开分享端点、外部 MCP 服务及技能执行。
自托管控制的是部署位置,不保证数据不外发:云端模型、解析服务、日志、追踪、浏览器和第三方沙箱都可能接触内容。密钥应最小权限、限制网络和日志输出。官方也建议生产采用内网/私有网络与防火墙,不直接把服务裸露到公网。
医院、律所等可以研究资料检索流程,但不能把原型回答当作诊疗或法律结论;敏感材料接入、保留和模型服务范围要先确认。
许可证与选型判断
根 LICENSE明确:WeKnora 自有代码采用 MIT,列出的第三方组件仍遵循各自许可证。GitHub 的 NOASSERTION 不是一种“非标准商用许可证”,不能替代读取实际许可文件。分发时仍应保留所需通知,第三方软件、模型和企业文档权利要分别核对。
我的判断是:它适合研究“同一知识底座服务问答、任务和 Wiki”的工程组织方式。是否比其他产品省心,取决于团队需求、部署能力、数据规则和实际评测,而不是维护组织、stars 或模块数量。
一句话总结:把知识组织起来只是第一步,让检索范围、来源和外部动作都可核查,才是企业知识工具能否落地的关键。