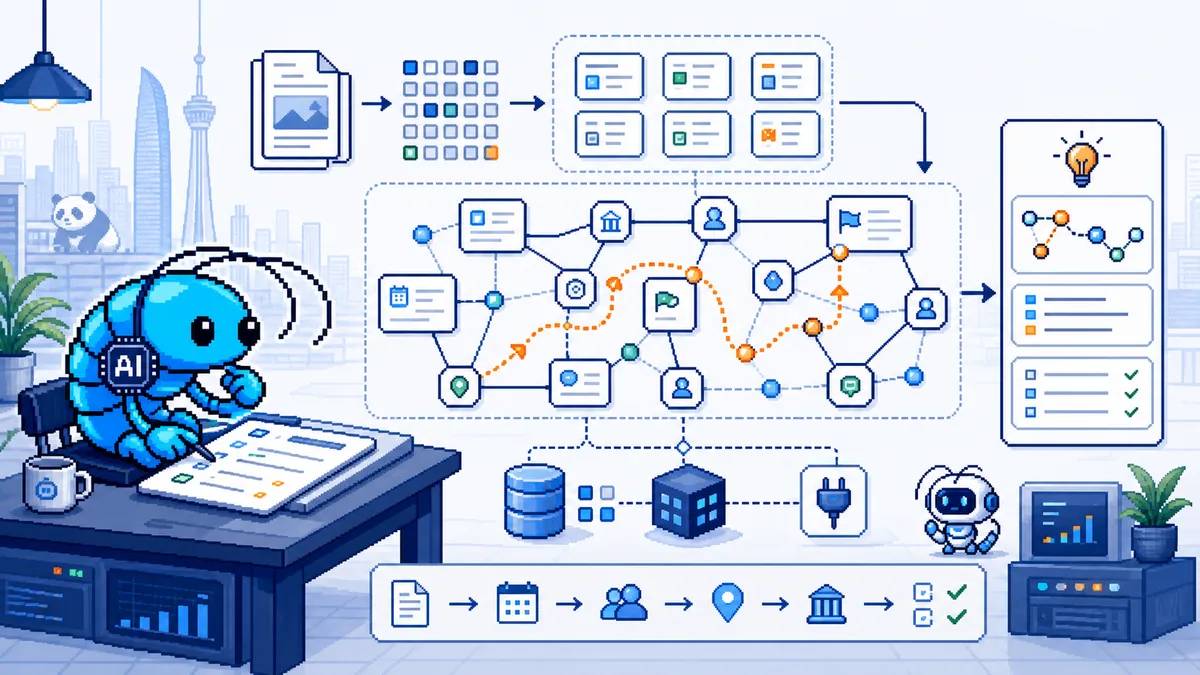
一个用事件-实体索引和查询时 SQL 关联扩展证据的 RAG 工作台。不是“完全不用向量”,论文成绩也不等于你的知识库效果。
「这是什么」一句话定性
我看重的是它给多跳检索提供了另一种工程组织方式:先找到事件,再通过共享实体把相关事件接起来,最后回到原文。不同于预先维护一张全局知识图谱,它在查询时激活局部关联。
仓库位置
应用是 Zleap-AI/SAG,论文实验另有 SAG-Benchmark。研究机制、复现实验和部署工作台是三件事,数据库与模型配置不能混为一谈。应用采用 MIT。
核心创新:索引结构
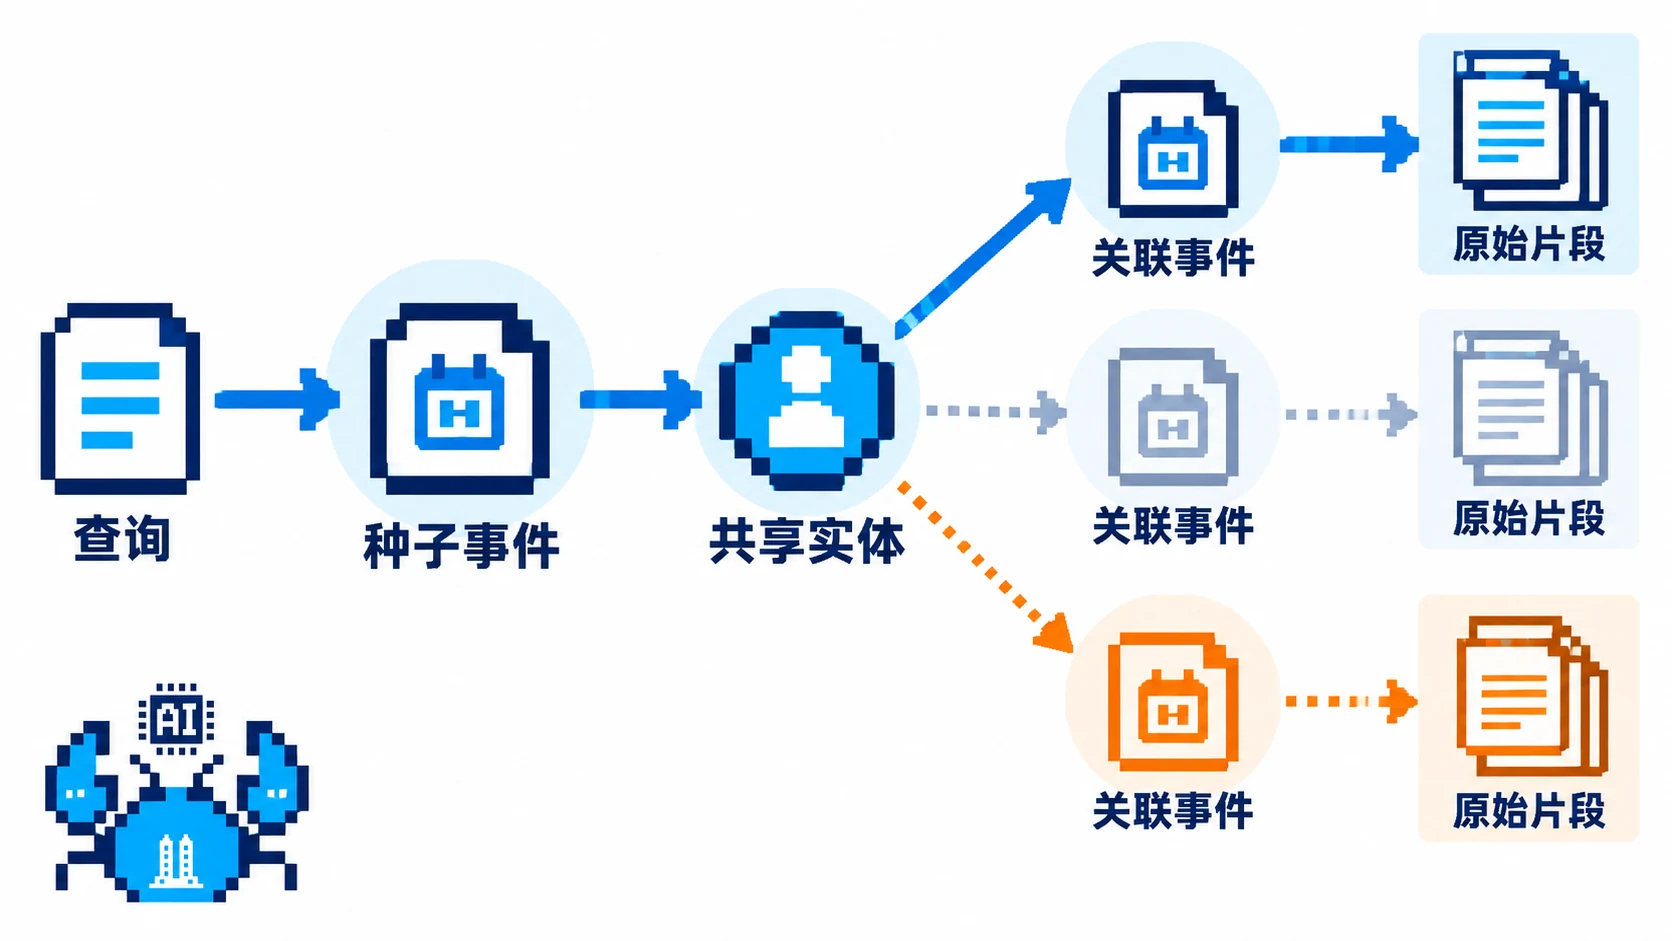
按应用 README,离线阶段解析并分块,用模型抽取事件和实体,将关联写入关系存储,同时保存向量/全文索引。在线阶段先找到种子,再用共享实体关联扩展候选,选择并去重,输出可追溯的原始 chunk。
所以,“没有独立图数据库”不等于“没有向量索引”;关系展开也不是替每条生成结论做事实证明。实体同名、别名和抽取错误都可能改变检索结果。
Benchmark 表现
论文 v2 的实验设置与表 1报告:每个多跳数据集抽样 1,000 个开发集问题,结构增强方法统一使用 BGE-Large-EN-v1.5 与 Qwen3.6-Flash。MuSiQue 的 SAG Recall@5 为 80.36%,比该表最强检索基线高 11.52 个百分点;三数据集平均 Recall@5/F1 为 90.07%/72.96%。
这是作者报告的特定基准结果,不是本次实测,也不是所有 RAG 的通用排名。旧文 Recall@2、不同分数和“比 HippoRAG 2 高 11 点”的组合不能继续沿用。论文还说明,在当前基准规模上并没有明确的端到端成本或延迟优势;别名处理与陈旧事件更新也是局限。中文专业语料需另做评估,既不能直接承诺有效,也不能凭英语基准断言中文一定差。
「它怎么转」逻辑全景图
文档 → 解析分块 → 事件/实体抽取 + embedding → 本地索引
问题 → 语义/词法种子 → 共享实体 SQL 关联 → 候选选择 → 原文与引用
当前产品提供 Fast(vector)、Fast(multi_es_fast)和 Precise(multi)等模式。模式名并不是统一质量等级,应在同一语料上看召回、引用正确率、响应时间与成本。
「怎么升级」三段位路线图
| 段位 | 目标 | 动作 |
|---|---|---|
| 入门 | 起服务、导入少量授权文档 | 按当前 Docker 指南启动,配置模型后等待索引 Ready |
| 进阶 | 检查检索是否找对原文 | 建小型金标问题集,对比检索模式和抽取质量 |
| 高手 | 扩展数据与 Agent 集成 | 固定模型/索引版本,评估 API/MCP 范围、增量写入和恢复 |
当前 Docker 快速启动:
git clone https://github.com/Zleap-AI/SAG.git
cd SAG
docker compose up -d --build
Web 为 http://localhost:3000,API 文档为 http://localhost:8000/docs。无 key 可以启动界面,不等于可以完成知识处理:embedding 用于索引/向量检索,LLM 用于抽取、查询理解和生成。
「能用在哪」场景迁移
跨文档的人物、组织、产品和事件追踪值得试;单文档即可回答的任务未必需要结构展开。企业知识库应先确认文档权限和来源,再检验答案是否真的由引用支持,而不是只看引用标记存在。
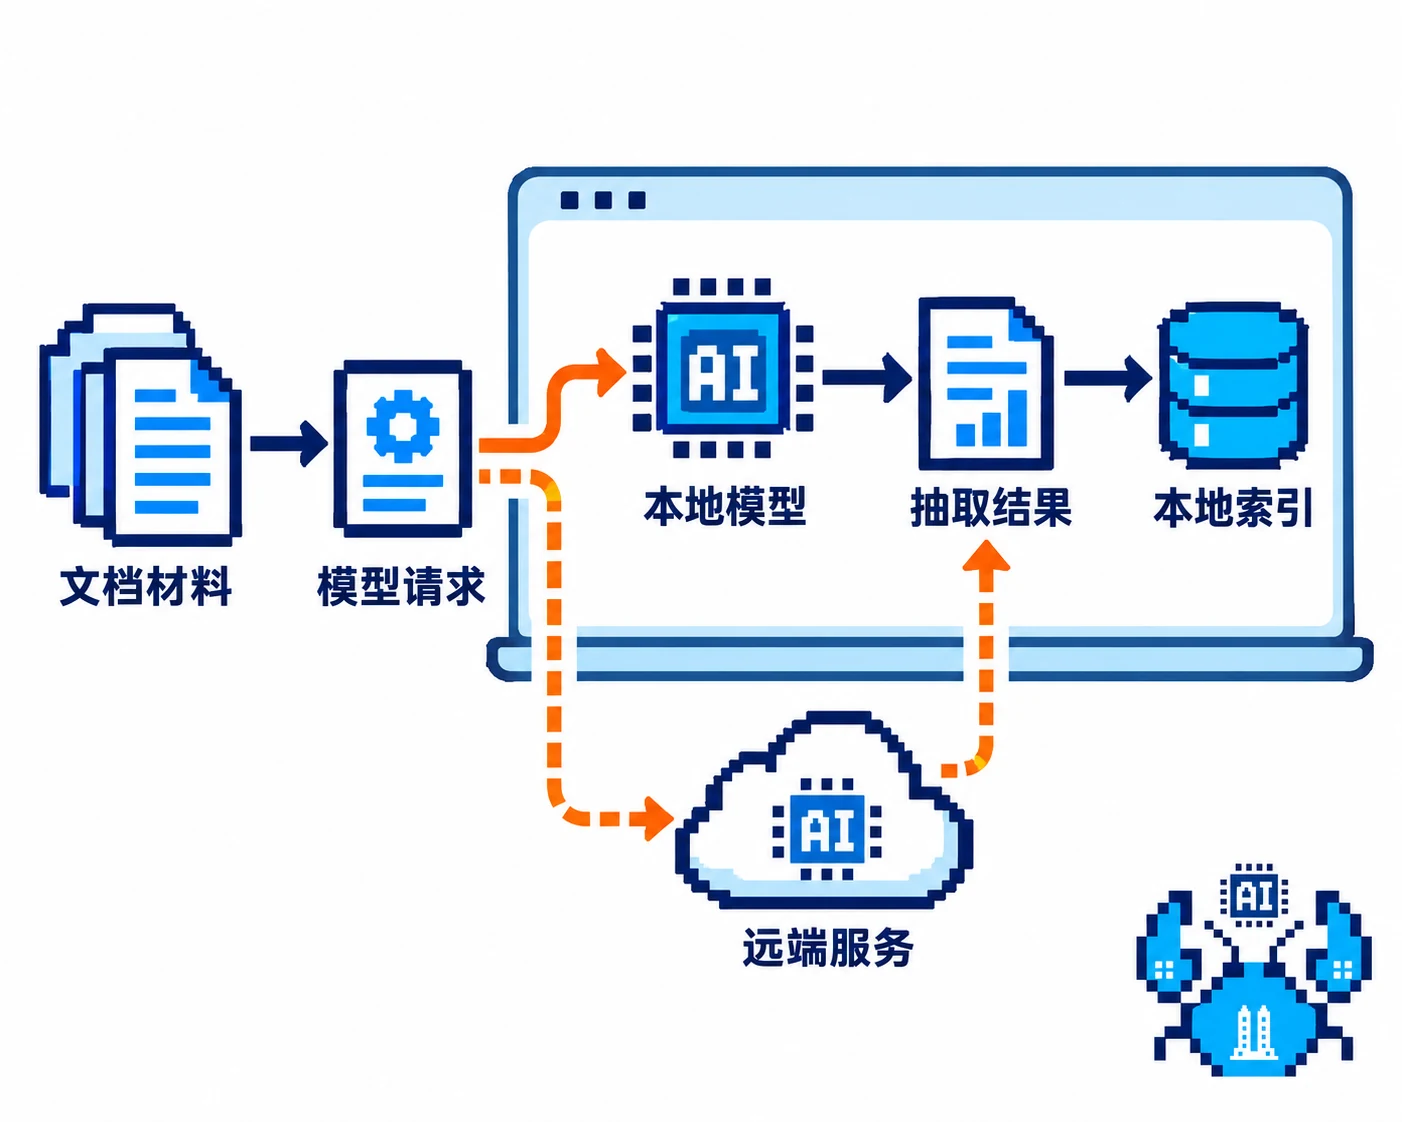
模型和解析器可能外发文档。当前提供远端模型配置,PDF 解析可涉及配置的 MinerU 服务,也有本地解析路径;具体数据去向要按实际选择确认。“local-first”描述产品存储与运行取向,不等于离线处理保证。
技术栈
当前默认是单用户、本地优先的 SQLite + LanceDB,不要求先装 PostgreSQL 17 和 pgvector;另有 PostgreSQL/pgvector 等生产后端路径。旧版 React/Fastify、5173/4173 端口与旧环境变量清单不再作为当前部署说明。
核心模块(按职责看)
关注摄取解析、分块抽取、索引持久化、关联检索、证据追踪及 Agent/API 集成,比记一份会过时的 src/ 文件表更有用。索引模型变化时按迁移说明重建/重导,不假设旧向量可直接复用。
一句话灵魂
不是给向量检索判死刑,而是让事件之间的连接也成为检索线索,再把选择结果交回原始证据核对。
资料核对:2026-10-13,读取官方应用文档、许可证、基准仓库及论文方法/实验/局限;未部署应用或复现实验,数字为作者报告。