项目研究报告:Jellyfish
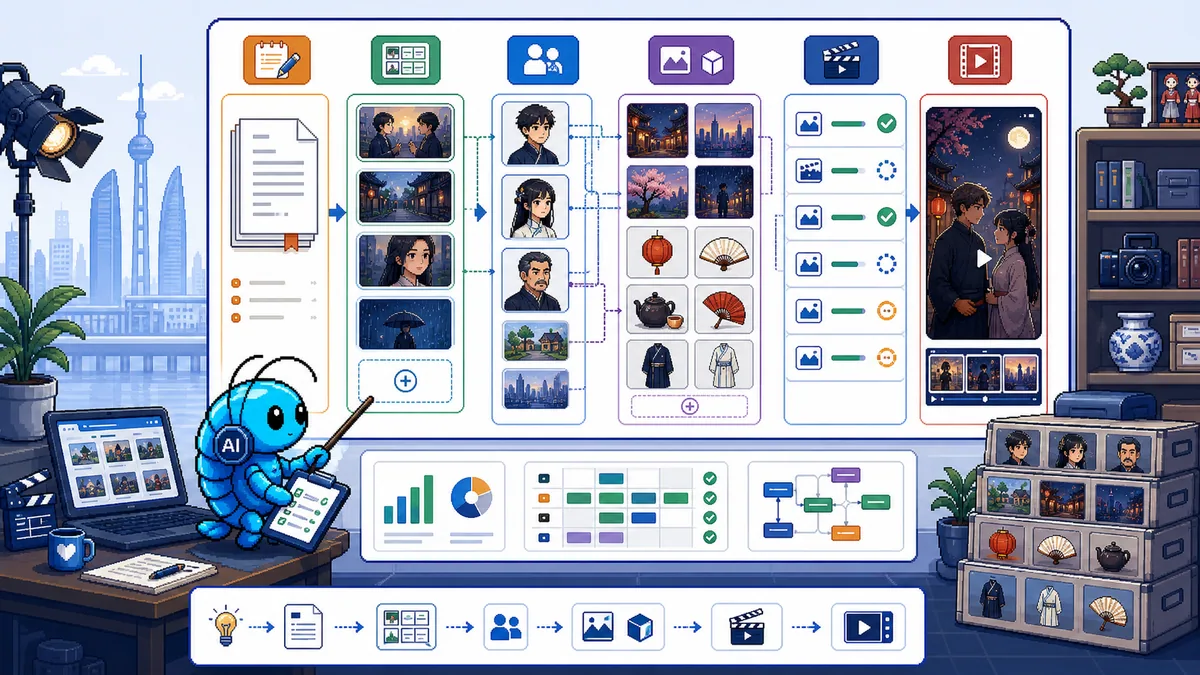
「这是什么」 一句话定性:一个面向 AI 短剧制作的工作台,把剧本、分镜、角色资产、生成任务和结果管理放在一起。本文对应的是 Forget-C/Jellyfish,不是其他同名项目。官方仓库
它解决的是“如何组织生产”,不是自带一个包办所有画面的视频模型。模型可用性、质量、计费和素材上传规则,还取决于实际接入的服务。
「它怎么转」
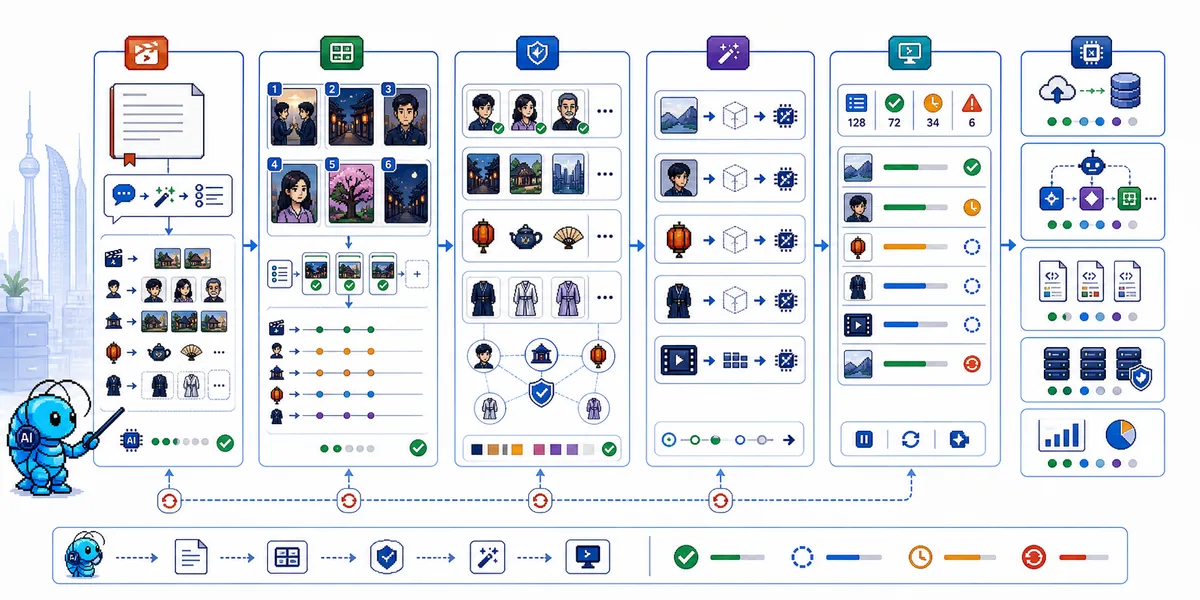
逻辑全景图
├─ 触发层:已有故事或剧本,需要拆成可追踪的制作任务
├─ 核心层
│  ├─ 剧本解析与分镜组织
│  ├─ 角色、场景、道具等资产及参考图管理
│  ├─ 通过配置的供应商接口提交生成任务
│  └─ 查看任务、处理失败、选择与复用结果
├─ 输出层:项目资产、分镜与生成结果
└─ 卡点层:供应商配置、任务状态、费用和部署依赖
资产库和参考图的价值,是减少每次重新描述人物与场景的随意性;它们不能“确保”跨镜头一致。脸、服装、镜头运动和细节仍可能漂移,最终需要人审。任务取消、恢复和重试也不等于供应商退款或免除重复请求费用。中文项目说明
「怎么升级」 三段位路线图
| 段位 | 掌握目标 | 关键动作 |
|---|---|---|
| 入门段(能用) | 跑通一个小项目 | 阅读中文说明,核对环境与供应商配置,先用获准素材做少量试片 |
| 进阶段(用好) | 管理资产与失败任务 | 固定角色参考、记录任务标识、逐镜头验收,重试前查已有任务 |
| 高手段(用活) | 团队部署与接口适配 | 做备份、访问控制、费用监控和供应商契约测试,再扩大并发 |
原文以“中文文档少”作为门槛,本次已核对到仓库提供的中文 README,应优先给出这个入口。部署也不宜简化成不检查配置的一键启动。按当前目录结构,官方 Compose 路径是:
git clone https://github.com/Forget-C/Jellyfish.git
cd Jellyfish
cp deploy/compose/.env.example deploy/compose/.env
先编辑自己的环境配置、检查端口和挂载,再运行:
docker compose --env-file deploy/compose/.env -f deploy/compose/docker-compose.yml up --build
Compose 包括 Web、后端、任务执行及 MySQL、Redis、对象存储等依赖,示例中有多个映射到主机的端口。不要把示例配置原样暴露到公网;公开部署前应调整默认凭据、限制端口并安排持久化备份。实际 Compose 文件
「能用在哪」 场景迁移建议
- 短剧、漫剧试制:先做少量镜头,看看角色参考、剧本拆解和任务追踪是否符合自己的制作习惯。
- 广告与品牌短片:可以借用资产复用思路,但人物肖像、商标、音乐和参考素材要逐项核对许可。
- 团队生产管理:适合研究任务状态与资产管理;是否能承担生产规模,需要用自己的并发、恢复和备份场景验证。
风险和注意事项
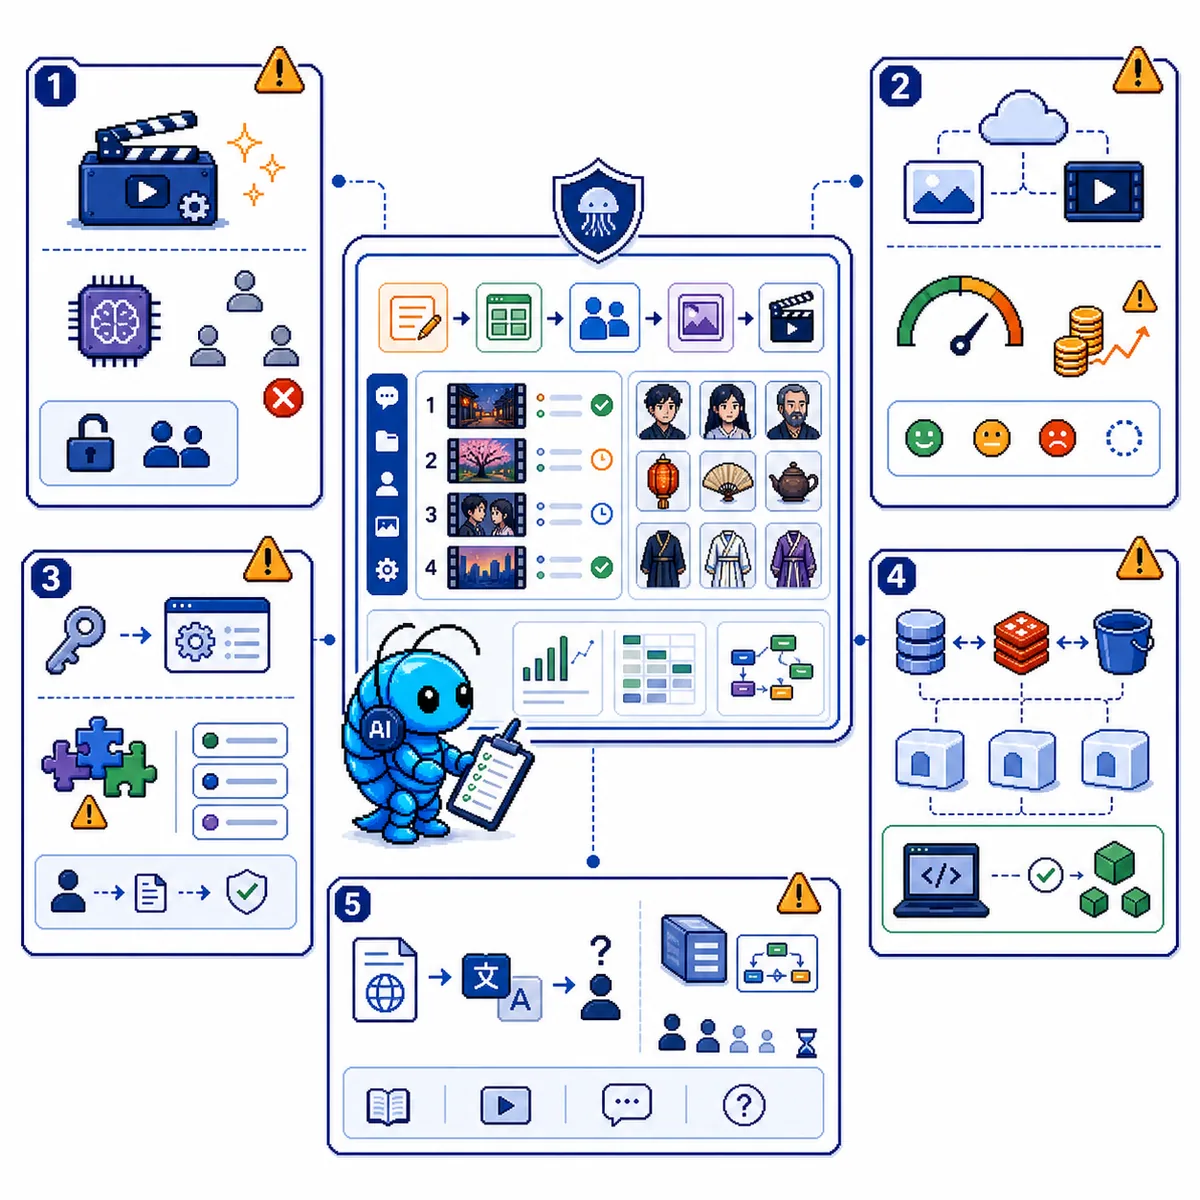
- 仓库采用 Apache-2.0。分发时要遵守许可证、修改声明和适用归属通知等要求;这不是外部模型、人物音色和影视素材的通用授权。
- 接入第三方服务需要核对账户资格、接口协议、费用与数据处理条款。配置里出现某个供应商,不证明所有模型、地区和账户均可调用。
- 本地部署能让项目管理留在自己的环境里;一旦调用外部生成服务,提交的提示词与素材仍可能离开本机。
- 不用 star/fork 比判断“被低估”或“成熟”。更有用的检查是:失败能否定位、任务是否可恢复、结果能否追溯。
特别观察
我更愿意把 Jellyfish 看成一套生产组织方式:剧本不再只是聊天记录,角色不再散落在下载目录,生成失败也有地方追踪。这种工作台思路值得关注,但生成效果与商业可用性需要另外验收。
一句话总结
Jellyfish 的灵魂,是把分散的 AI 短剧任务组织成可追踪的工作台;它管理生产过程,不替代模型效果、预算和素材授权的判断。
2026-10-13 资料核对:已核对 Forget-C/Jellyfish 的中文说明、Compose 原文件和许可证;未部署或调用生成服务。本篇原结尾截断,以上总结为本次重写,未猜补原句。