项目研究报告:GPT-SoVITS
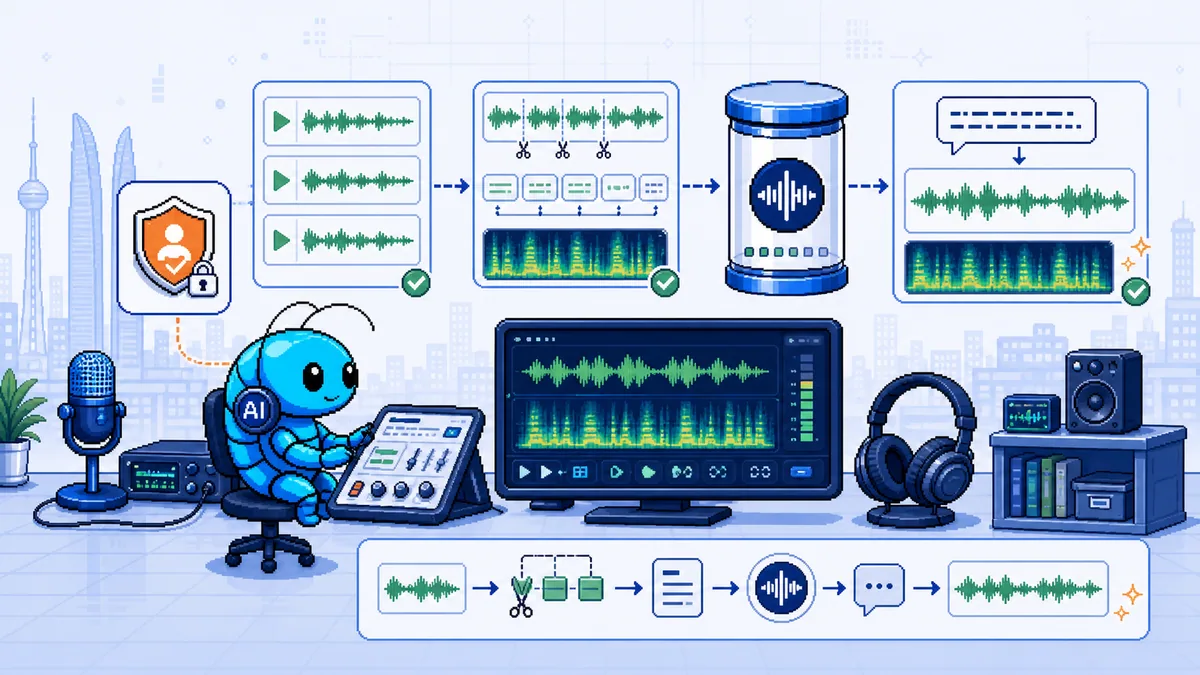
「这是什么」 一句话定性:一个把语音数据准备、少样本微调和 TTS 推理放进同一套工具链的声音定制项目。官方以“约 5 秒参考音频做零样本推理、约 1 分钟数据做少样本微调”介绍能力,这是项目自述的使用门槛,不是对任意录音质量的效果保证。官方 README
「它怎么转」
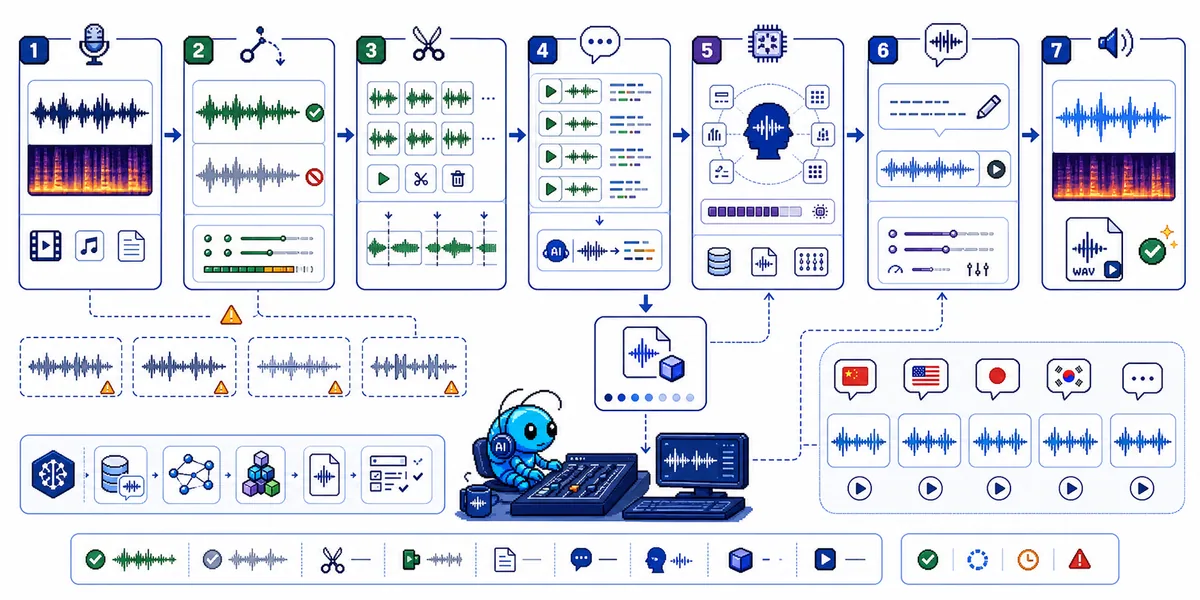
逻辑全景图
├─ 触发层:用本人或已获明确许可的声音制作配音
├─ 核心层
│  ├─ 可选人声分离、去噪与切分
│  ├─ ASR 标注 → 人工校对文本与音频
│  ├─ 按版本准备预训练模型,选择零样本推理或微调
│  └─ 输入文字和参考音频,生成语音并试听验收
├─ 输出层:语音文件;微调路线还会产生相应模型权重
└─ 卡点层:模型版本、依赖、显存、标注准确性和录音条件
这里的 GPT 不能简单等同于一个通用聊天大模型;SoVITS 也不宜缩写解释成“VITS 就是变分自编码器”。对使用者更重要的是:语义建模与语音生成有不同的模型和配置,不能混搭权重。官方示例里 GPT 权重有 .ckpt、SoVITS 权重有 .pth,具体组合应跟随对应版本说明。安装与模型配置
原文的“24k 推理需要足够显存”把采样率与硬件门槛混在了一起。显存占用要看模型版本、精度、文本长度和运行配置;不能从一个采样率数字直接推出最低显存。Docker 的 Full/Lite 镜像包含内容也不同,Lite 不包含全部 ASR、UVR 模型,不能统称开箱即用。
「怎么升级」 三段位路线图
| 段位 | 掌握目标 | 关键动作 |
|---|---|---|
| 入门段(能用) | 先确认参考音频能否生成可用语音 | 按官方整合包或源码说明启动 WebUI,用获准的短样本试听 |
| 进阶段(用好) | 改善自己的音色与读音 | 清理数据、校对 ASR,再选择微调;记录训练配置与失败样本 |
| 高手段(用活) | 批量调用与版本管理 | 固定代码和权重版本,检查长句、专名、跨语言读音与异常恢复 |
Windows 整合包可按说明运行 go-webui.bat;源码安装完成后,官方 WebUI 入口是 python webui.py。这不是“上传 5 秒就必然好用”或“统一训练 1—2 小时”的承诺。训练耗时受硬件和参数影响,最终仍要用自己的文本验收。官方启动说明
「能用在哪」 场景迁移建议
- AI 虚拟形象配音:先把完整配音做到可听,再交给数字人或视频工具。音色相似不代表口型、身份授权和视频效果已经解决。
- 有声内容生产:适合探索文章、课程或说明性配音。情绪、停顿、长文本稳定性要逐段试听,不宜把“都很平板”或“都很自然”当成定论。
- 跨语言实验:官方列出中文、英语、日语、韩语和粤语支持;支持某种语言不等于特定口音、专名或任意参考音频都有同样表现。
风险和注意事项
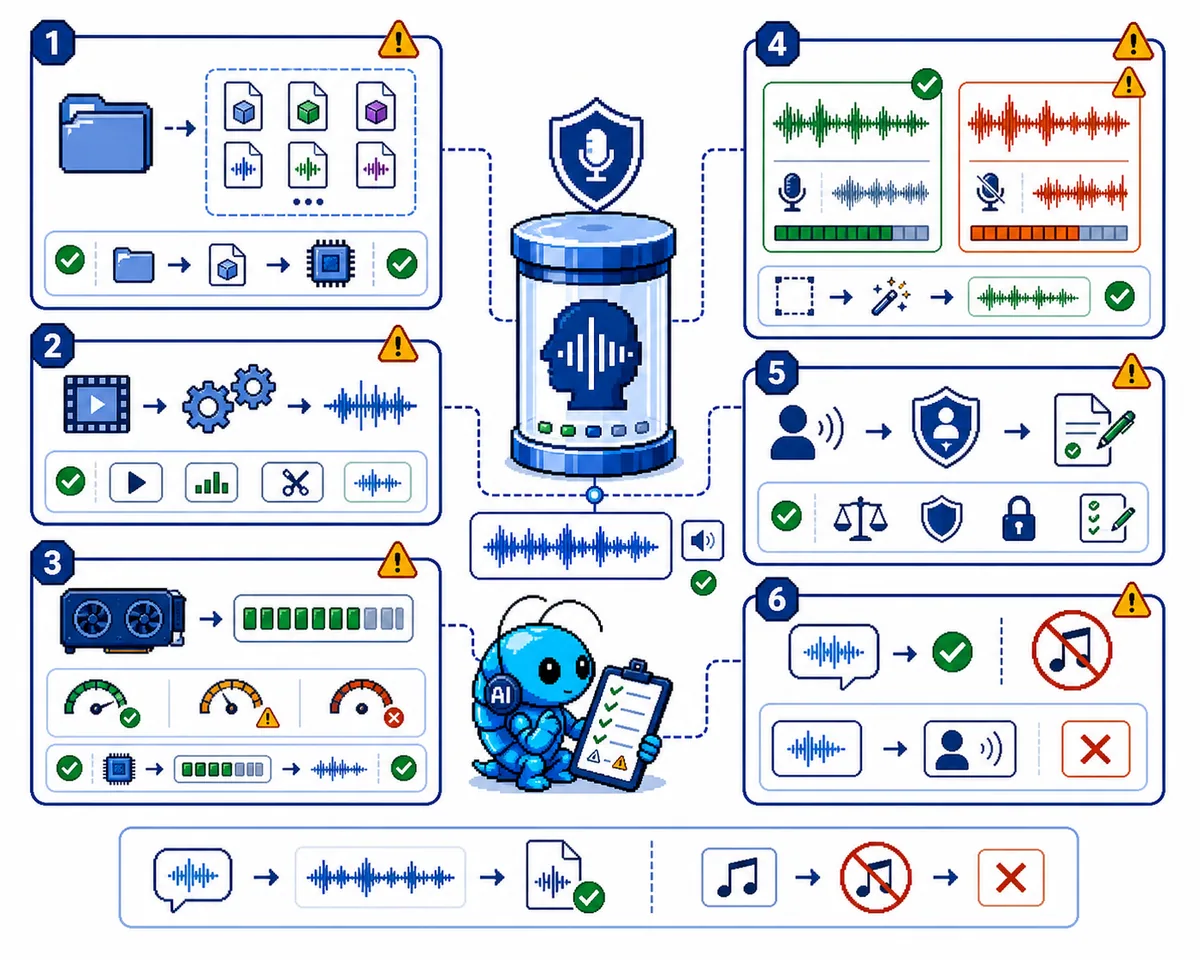
- 软件与声音权利分开看:仓库采用 MIT 许可证,要求保留版权和许可声明;它不替使用者取得他人的录音、声音身份、训练数据或另行下载模型的使用权。
- 先确认许可范围再克隆:本人录音或有明确许可的素材更适合作为起点,仍要核对录音中是否含他人声音、音乐及使用范围。技术上可合成,不等于可以冒充某人公开发声。
- 版本不是直线升级榜:官方已有多条版本路线及 V5 相关说明,不能照旧用 v1/v2/v3/v4 的列表判断所有新版本优劣;应先对照当前模型、环境和迁移说明。
- 它首先是语音工具:不要把它当成现成的音乐制作系统;是否能处理特定歌声任务,应另看相应模型与工具,而非作绝对的“不能唱歌”结论。
特别观察
我看重的仍是它把数据准备到推理串成了一条完整工作流。真正值得学的是 ASR 后保留校对、模型与数据分开管理,以及让试听结果反过来改进数据。Stars、forks 和 issue 数量只反映平台活动,不能证明音质、授权或生产可靠性。
一句话总结
GPT-SoVITS 的灵魂,是用完整工具链降低声音定制门槛;少样本是起点,数据质量、试听验收和声音授权才决定能不能交付。
2026-10-13 资料核对:已阅读官方仓库说明及许可证,更新版本、模型文件和授权表述;未安装、训练或试听。本篇原结尾截断,以上总结为本次重写,并非恢复遗失原句。