项目研究报告:Kronos
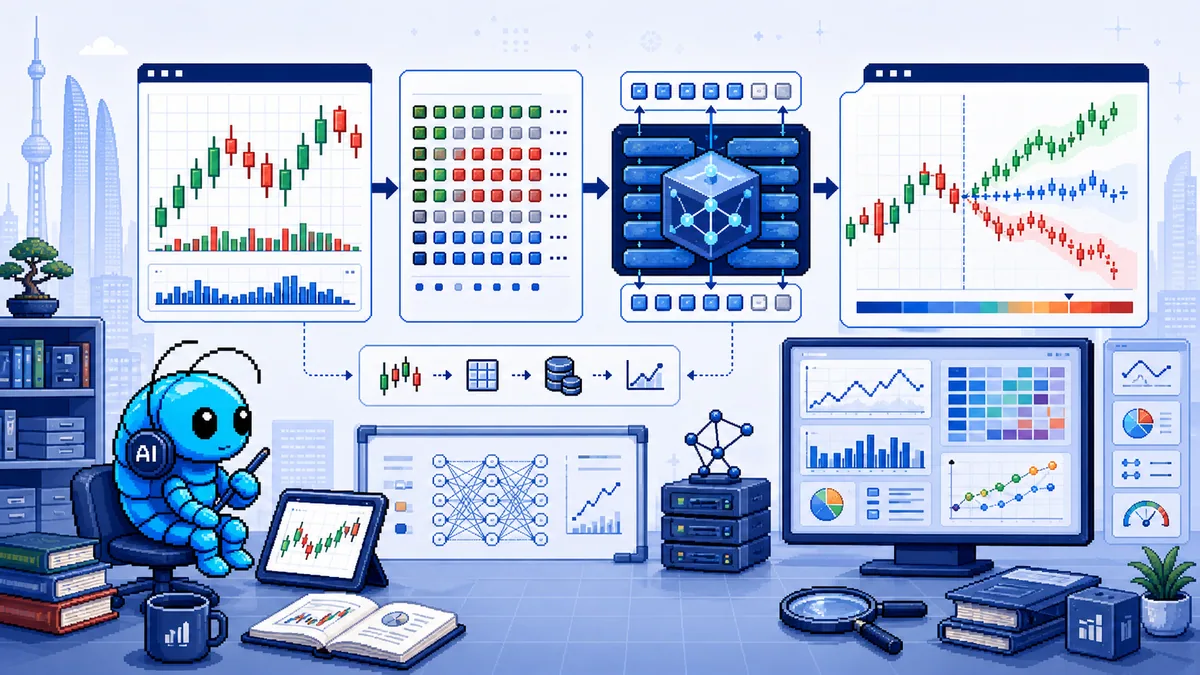
「这是什么」 一句话定性:一个专门训练在 K 线(蜡烛图)数据上的基础大模型——把金融市场的 K 线语言(OHLCV) token 化后做自回归预训练,目标是成为各种量化任务的统一底座。
「它怎么转」
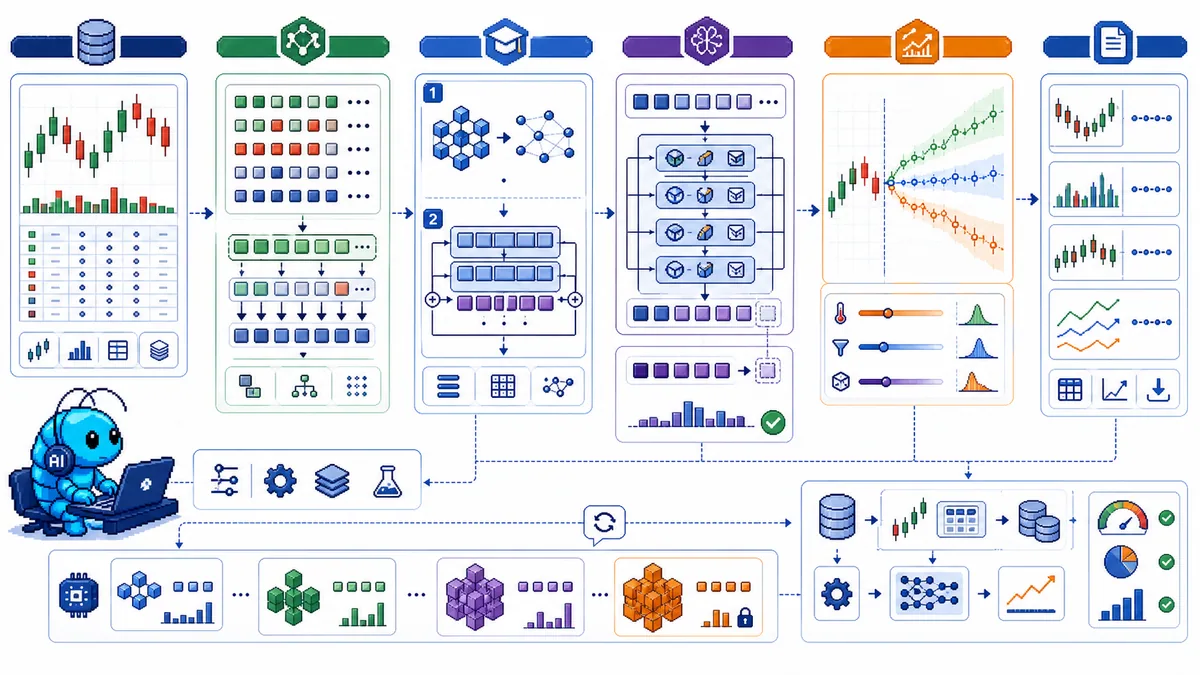
逻辑全景图
├─ 触发层:什么情况下需要用它?
│   └─ 想用深度学习预测金融价格走势,但:
│       → 想比较通用时间序列模型与金融 K 线专用预训练的差别
│       → 金融数据是高噪声、模式复杂的序列
│       → 想用一个模型搞定多种量化任务(预测/分类/异常检测)
│
├─ 核心层:它的关键动作是什么?
│   ├─ K 线 Tokenizer → 把连续的 OHLCV 多维数据量化成层级离散 token
│   ├─ 两阶段训练 → 先训 tokenizer(学 K 线结构),再训 Transformer(学序列模式)
│   ├─ 自回归预训练 → 在离散 token 序列上做 next-token prediction
│   ├─ 微调适配 → 用 Qlib 准备 A 股数据,做 backtest 验证
│   └─ 概率预测 → 支持 temperature / top_p / 多路径采样输出
│
├─ 输出层:最终产出什么?
│   ├─ 预测结果:未来 N 个时间步的 OHLCV 预测值
│   ├─ 多模型规格:mini(4.1M) / small(24.7M) / base(102.3M) / large(499.2M)
│   ├─ HuggingFace 权重(mini/small/base 开源)
│   ├─ Live Demo(BTC/USDT 24小时预测可视化)
│   └─ Qlib 微调 pipeline + backtest
│
└─ 卡点层:新手最容易在哪里卡住?
    ├─ Context length 限制 → small/base 是 512,lookback 超过会截断
    ├─ Qlib 数据准备复杂 → 需要先搭 Qlib 环境,准备本地数据
    ├─ 训练资源门槛 → 官方例程使用 torchrun;所需 GPU 数和显存取决于模型、批量与配置,不能把多卡写成普遍硬性要求
    └─ 概率预测调参 → T / top_p / sample_count 不同取值影响结果
「怎么升级」 三段位路线图
| 段位 | 掌握目标 | 关键动作 |
|---|---|---|
| 入门段(能用) | 跑通预测 demo | 安装 requirements → 下载 HuggingFace 权重 → 跑 examples/prediction_example.py |
| 进阶段(用好) | 微调到自己的数据 | 用 Qlib 准备数据 → 两阶段微调(tokenizer → predictor)→ 回测验证 |
| 高手段(用活) | 二次研究 / 论文贡献 | 读 arXiv 论文 → 理解 tokenization 逻辑 → 贡献新任务 adapter |
「能用在哪」 场景迁移建议
-
迁移到其他金融序列(加密货币/期货/外汇) - 变量:可复用 K 线序列建模思路,但需重新核对价格复权、成交量单位、交易日历、缺失值及数据许可,不能只换数据源就直接比较结果。 - 注意:先做按时间切分的样本外评估,再决定是否微调;要防止未来信息泄露和回测选择偏差。
-
迁移到非金融 K 线数据(如心电图、工业传感器时序) - 变量:把 OHLCV 换成其他多维时序信号;核心 tokenization 思想可迁移 - 注意:需要重新训 tokenizer,金融 K 线的统计特性与其他序列差异大
-
如果部署了这个项目,好处是: - 有了一个专门理解金融市场语言的预训练模型,不需要从零训 - 仓库公告论文获 AAAI 2026 接收,可作为阅读研究方法的线索,不等于有效收益或生产可靠性的认证。 - 已发布权重可本地运行;数据是否外发仍取决于下载、遥测、实验追踪和部署配置,不能保证天然不泄露。
-
风险和注意事项:
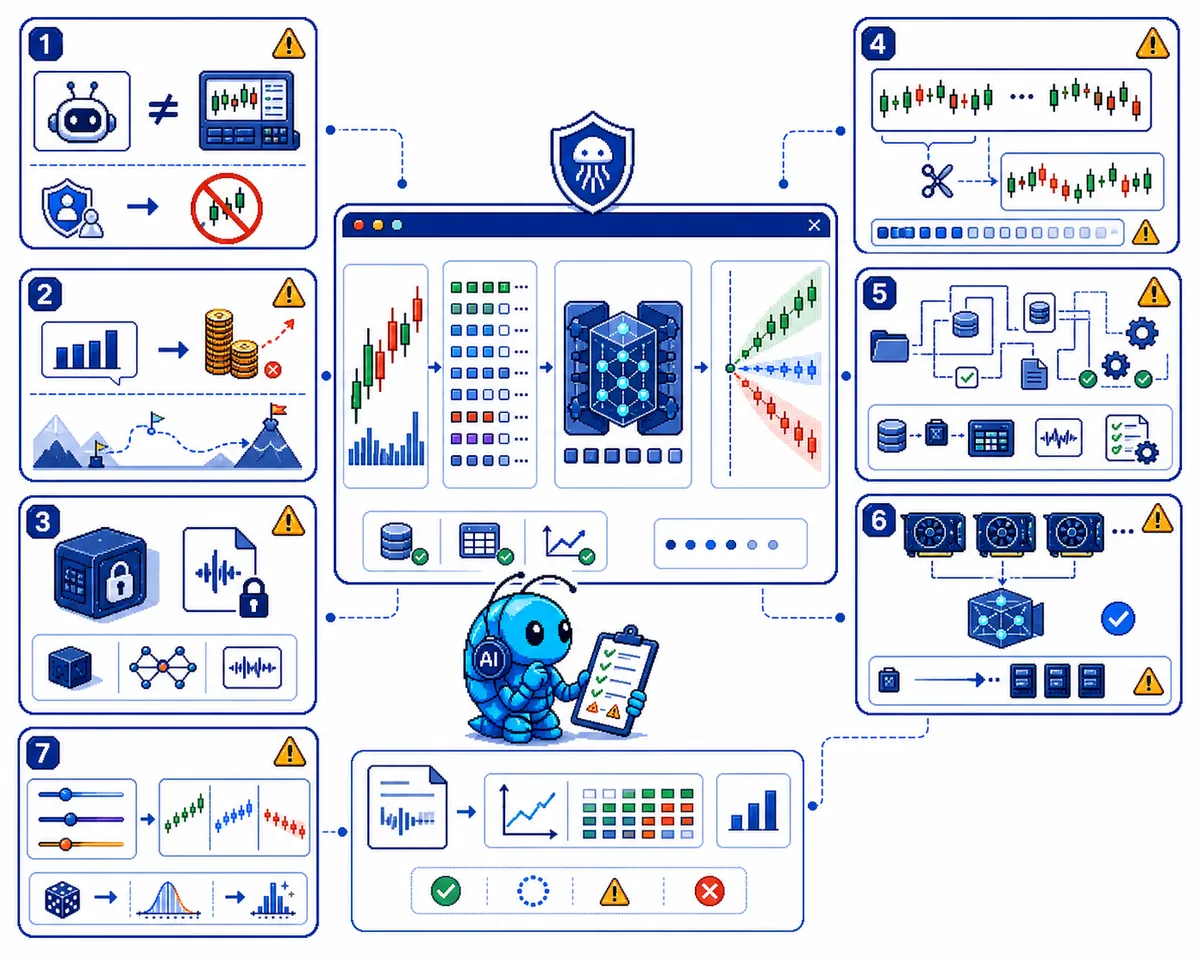
- ⚠️ 这不是交易策略:README 明确说"不是生产级量化交易系统"
- ⚠️ large 权重未列为公开发布:核对时官方模型表仍对 499.2M 参数 large 标记未开放;不推断今后永远不发布。
- ⚠️ 预测不等于赚钱:模型可以预测价格,但不代表预测能变成可执行策略
- ⚠️ 回测不是实盘收益:应纳入交易成本、滑点、流动性和市场冲击,分别检查数据泄露、基准选择及跨时段稳健性。不能用 issue 数判断性能,也不构成投资建议。
🔍 特别观察
社区数字不作为质量判断:原文的 star、fork、issue 和项目年龄没有配套快照,本次移除。fork/star 比例没有公认的“正常值”,不能据此判定技术质量。
这才是真正的技术项目。和之前研究的几个"流量型"项目不同,Kronos 有:
- 有可追溯研究材料:论文与训练语料范围可在原论文核对;45 家交易所是作者报告的语料覆盖,不代表所有市场都有效。
- 技术含量高:K 线 tokenization + 两阶段训练 + 分层离散表示,不是简单包装
- 工具链完整:HuggingFace 权重 + Live Demo + 微调脚本 + Qlib backtest pipeline
- 专注单一任务:不吹全能,只做 K 线序列预测,边界清晰
最值得注意的点:它把金融 K 线当成一种序列语言,用离散 tokenizer 和自回归方法建模。官方自称首个开源金融 K 线基础模型;这里不把“首个”的特定范围扩大为从未有人把金融数据 token 化。创新性和泛化效果仍需结合相关工作及可复现实验判断。
一句话总结
Kronos 的灵魂是"把金融市场 K 线变成可学习的语言 token",本质是一个面向金融时序的自回归基础模型——有真实技术含量,适合做量化研究的人微调使用,但距离实际赚钱的交易系统还很远。
GitHub:shiyu-coder/Kronos 论文:arXiv:2508.02739 技术栈:Python + PyTorch + HuggingFace + Qlib 模型规格:Kronos-mini(4.1M) / small(24.7M) / base(102.3M) / large(499.2M,核对时未发布权重);mini 上下文为 2048,small/base 为 512,使用时匹配各自 tokenizer。
资料核对:2026-10-13,依据官方模型表与微调说明和上述论文。本次没有重新训练、回测或验证实盘收益。