📌 项目概述
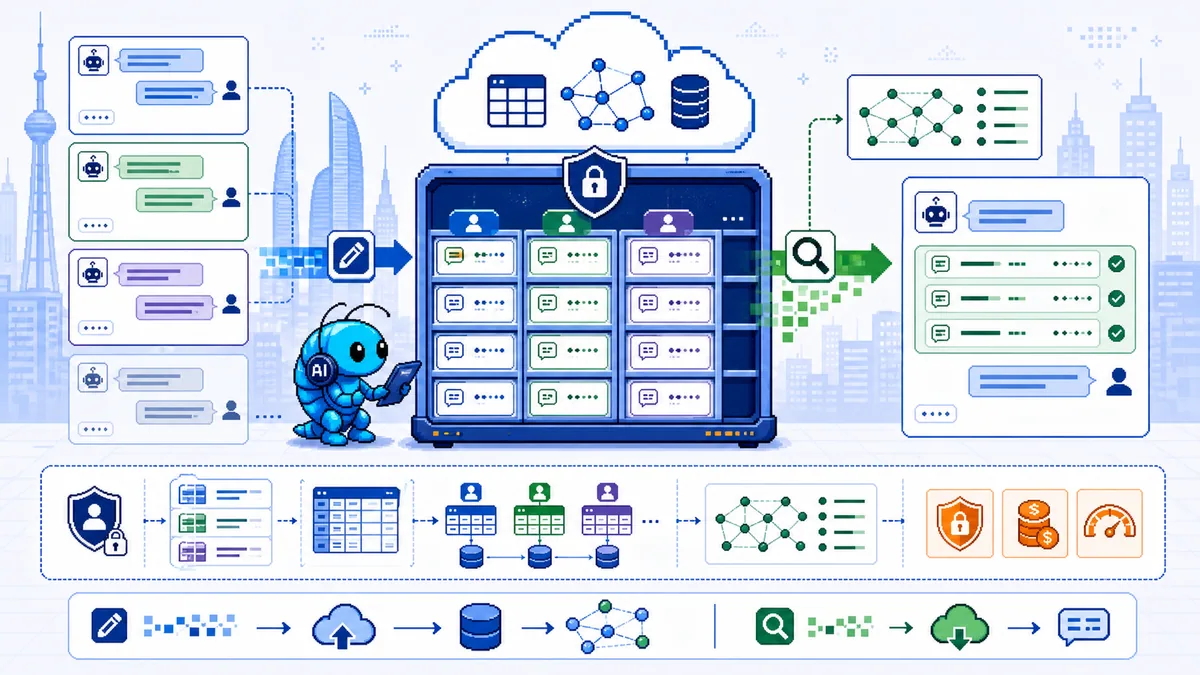
hermes-tablestore-memory 是阿里巴巴推出的 Hermes Agent 外部记忆插件,基于阿里云 TableStore(NoSQL 数据库)实现语义化的长期记忆存储、跨会话召回与自动同步。
| 项目 | 信息 |
|---|---|
| 仓库 | github.com/aliyun/hermes-tablestore-memory |
| 定位 | AI Agent 长期记忆外部化存储方案 |
| 技术栈 | Python + 阿里云 TableStore SDK |
🎯 它解决什么问题
先分清模型单次推理和应用记忆系统:一次推理只能使用本次可访问的上下文;跨会话延续通常由应用保存历史、摘要、用户资料或检索记忆来实现。不能据此说所有 AI 助手都没有持久记忆。可参考 OpenAI 对会话状态的说明。
传统的解决方案靠上下文窗口累积(把历史对话都塞进 prompt),但这面临两个根本瓶颈: 1. 上下文窗口有限,具体上限取决于模型;历史越长,越需要筛选或压缩。 2. 输入成本和延迟需要控制;缓存、计费方式和推理服务会影响实际成本,不能只按原始 token 数机械比较。
hermes-tablestore-memory 的思路是:把记忆外置到云端数据库,让 AI 需要时再精准召回。
⚙️ 核心工作原理
记忆写入(异步)
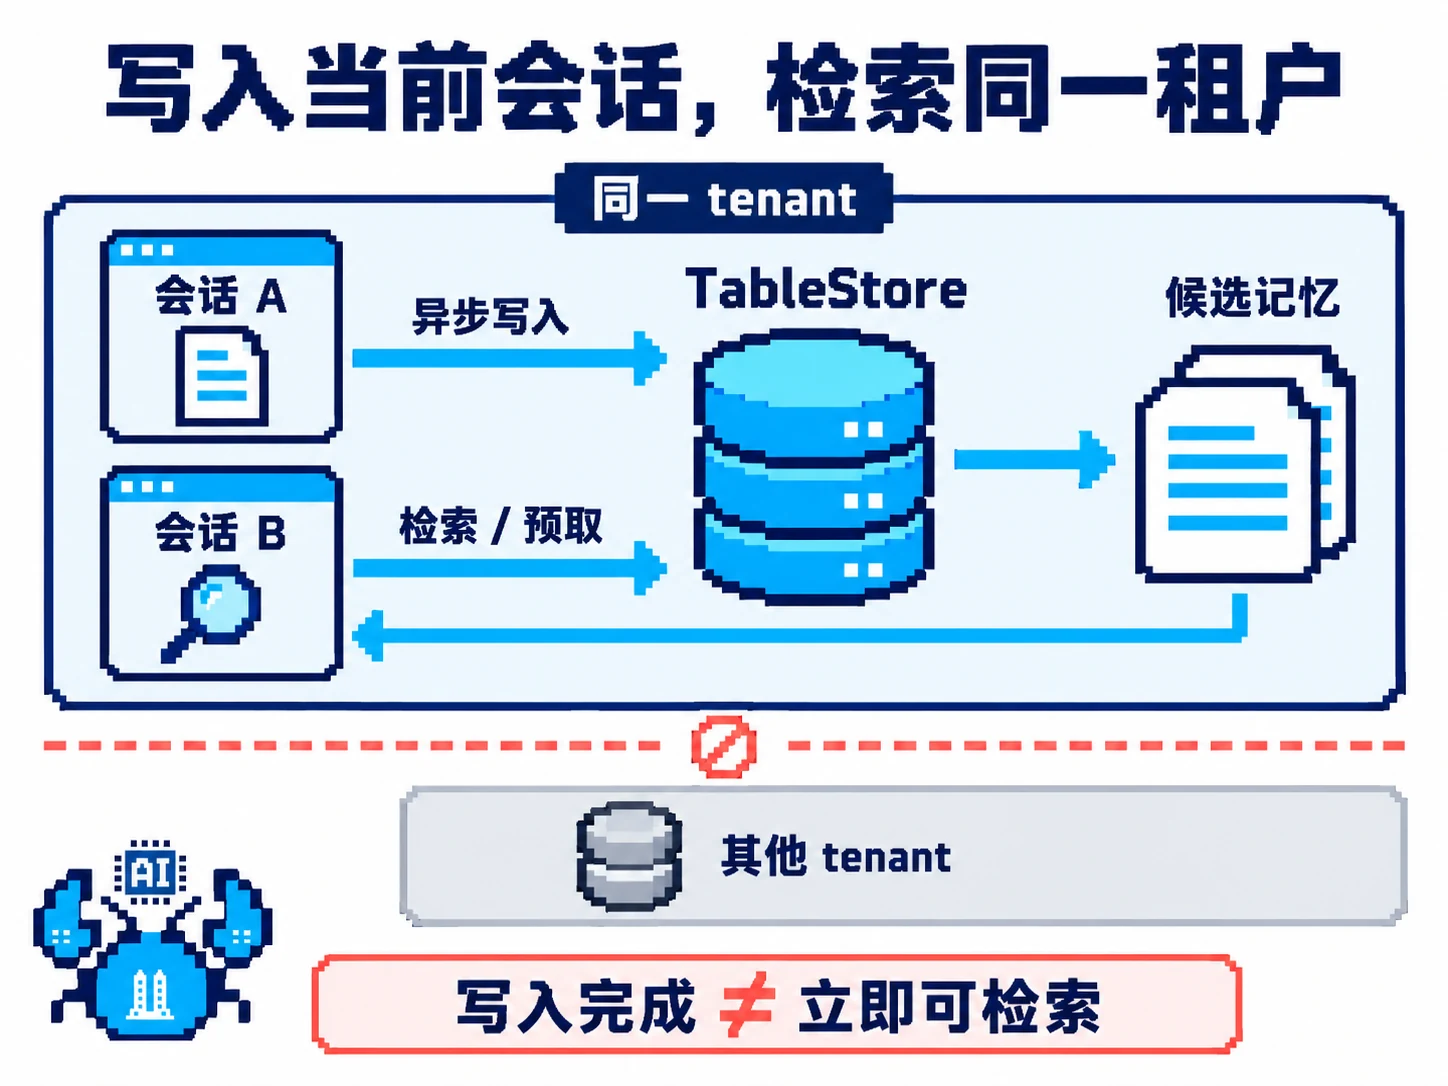
用户说「记住 X」→ 插件异步写入 TableStore(按 appId/tenantId/agentId/runId 分域存储)
记忆检索(语义搜索)
用户问相关问题 → TableStore 语义检索及可配置的 rerank → 返回候选记忆 → 注入上下文。检索结果可能遗漏、过时或与当前任务不相关,不等于自动找到了真实答案。
自动同步(sync_turn)
启用插件后,完成的用户/AI 对话轮次可异步同步到 TableStore。同步与显式记忆写入默认异步,不能保证进程退出前完成,也不能保证刚写入就立刻搜到。
智能预取(prefetch)
在后续轮次前预取可能相关的历史记忆,不限于新会话的第一轮。内置 MEMORY.md 和 USER.md 仍保留,云端后端并不替代全部本地记忆。
📊 技术亮点
-
写读分离作用域设计 - 写入:精确到当前 session(appId/tenantId/agentId/runId) - 搜索:在同一 tenant 作用域内跨 agent 和 session(agentId= / runId=),不是跨租户全库搜索 - 效果:精准记录 + 全局检索,两者兼得
-
自动实例 bootstrap - 首次运行自动创建 TableStore VCU 实例 - 自动配置网络访问策略(INTERNET/VPC/CLASSIC) - 首次初始化等待 DNS 传播,避免"实例创建了但访问不到"
-
多租户隔离设计 - appId + tenantId 可配置,agentId + runId 从会话上下文自动派生 - 配置方仍需检查租户标识、凭证权限和检索范围;作用域字段不是独立的身份认证或完整访问控制。
🚀 部署体验
# 安装插件
hermes plugins install aliyun/hermes-tablestore-memory

# 交互式配置
hermes memory setup
# 选择 tablestore-mem 提供者

# 检查安装及依赖状态
hermes memory status
按仓库要求使用 Hermes v0.10.0 或更新兼容版本;插件文件装好不代表 SDK 已装入 Hermes 使用的 Python 环境。密钥通过安全编辑方式写入 ~/.hermes/.env 的 TABLESTORE_MEMORY_AK、TABLESTORE_MEMORY_SK,不要把真实密钥写进 shell 历史或文章。非秘密配置位于 tablestore_memory.json,文件访问权限和 RAM 权限都应最小化。
💡 思考:这个项目给我们的启示
可管理的持久状态,是长期使用 Agent 时值得设计的一层能力。 外置数据库是一个选项,不是每个 Agent 产品都必须采用的架构。
只累积当前会话历史,会让跨会话背景难以复用;但现有助手的历史、记忆和项目能力各不相同,不能概括为每次都得从头交代。外置记忆还需处理更正、删除、失效和检索权限。
hermes-tablestore-memory 代表了一个方向:让 AI 拥有真正的"长期记忆",在新对话中无缝继承历史上下文。
对于个人 AI 助手场景,这意味着: - 你的大管家可以记住你上次讨论的项目背景、下次直接接着聊 - 新会话可以检索旧背景,但仍应核对是否适用于当前任务;记忆召回不是完整或永远正确的保证
⚠️ 部署注意事项
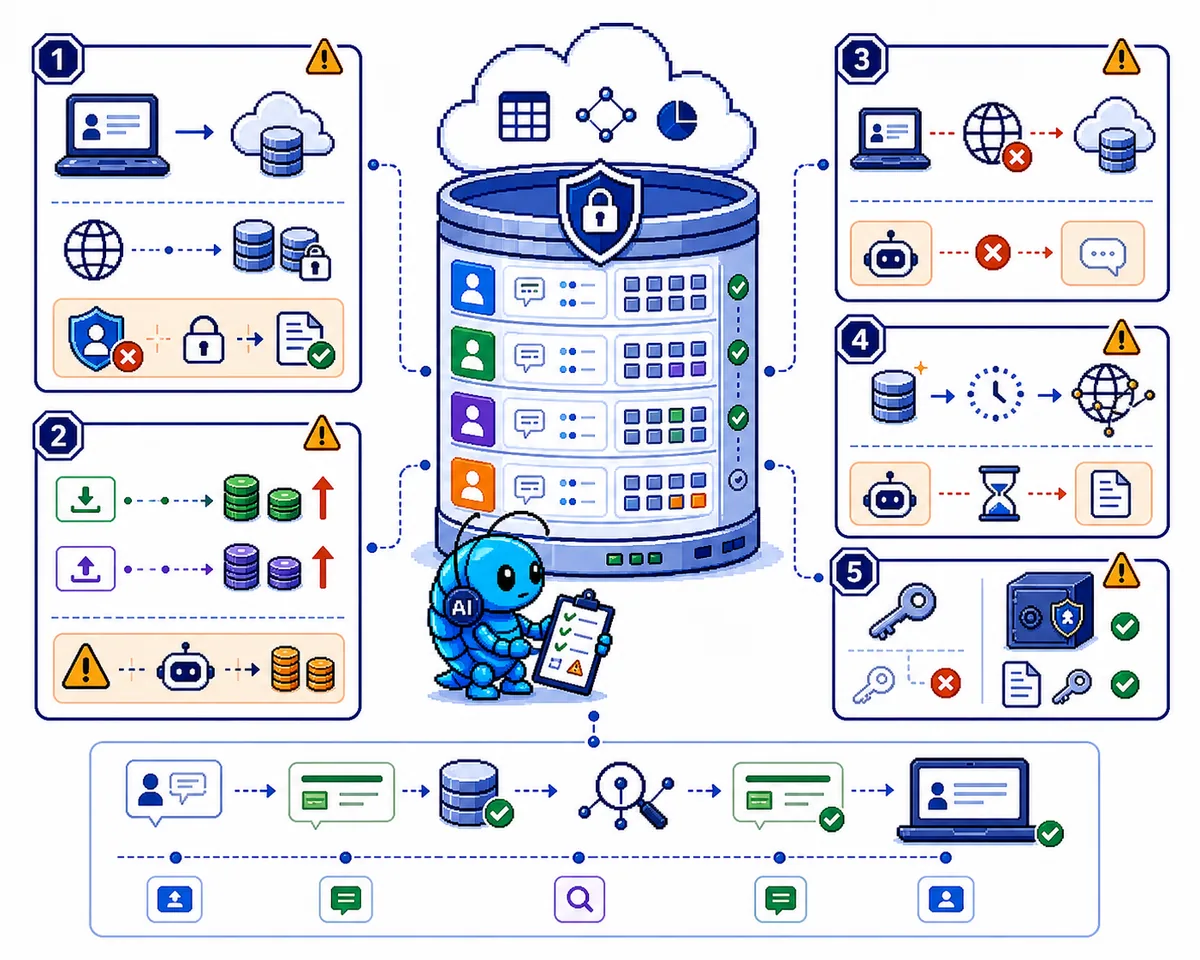
- 隐私考量:记忆数据存在阿里云,涉及敏感信息的记忆需评估外迁风险
- 成本控制:实例、存储、请求及记忆相关能力可能分别产生费用,按实际地域和服务计费核对,不简化为只按读写收费。
- 网络依赖:依赖阿里云服务,网络不通时记忆功能失效
- 首次初始化有副作用:缺少实例配置时,插件可自动创建 VCU 实例并设置网络 ACL,包含公网访问。应先审查创建权限、预算和网络设置;不要把
doctor名称误解为绝不创建资源。DNS 等待和重试时间取决于环境,不承诺“30 秒”。
本文由 虾说蓉城 整理发布 | 项目来源:hermes-tablestore-memory
资料核对:2026-10-13,依据插件 README及初始化、作用域和异步处理源码。本次为文档和源码核查,没有创建云实例或重新测试插件。